YEEZEON LI’S — 李宜臻 · SPECIMEN 01 · 苔光 MOSS-LIGHT

李宜臻 Yeezeon Li · 作品集 Portfolio

字标:作品集 Portfolio.「作品集」三字取自 Noto Serif SC w600、「Portfolio.」取自 Hoefler Italic,描摹为贝塞尔路径后按技术制图语汇重绘:暗实心字面 + 亮轮廓描边,叠加基线/字高/字宽的尺寸标注线与构造锚点。源 _pdf_check/_gen_S145_wordmark.py。
CAP · 127px
P₀ · 研究起点
MEASURED BY · 研究 → 洞察 → 原型 → 验证
验证 VALIDATE
W · 925px

用研究找到真需求,再用数据验证每个体验决策。

图号 SHEET01 / 43
时期 PERIOD2025—2026
方向 DISCIPLINE产品体验设计师 · UX · AI 产品
院校 · 联系 CONTACTPolyU MSc IME · 2027 应届
yeezeon.li@connect.polyu.hk
01

自我介绍 / About Me

用研驱动 · 数据闭环 · AI 工作流 — 全链路体验设计师

用研驱动、策略制定、数据闭环的全链路体验设计师。擅长在模糊需求中定义核心问题,通过混合研究方法洞察用户需求,以可测试原型替代抽象讨论,用数据支撑每一个设计决策。横跨数字产品与沉浸式体验,具备多款 AI 工具组合实战与工作流搭建能力。

核心能力

01
用研闭环RESEARCH LOOP

混合方法(深度访谈 · 田野 · 问卷 · 可用性测试)驱动决策,数据验证每个节点

愿境 · N=17 展后问卷 · 11/17 报告情绪释放

02产品思维PRODUCT THINKING

在模糊需求中识别真实痛点,用「通过 X 改变 Y 达成 Z」框定设计范围

愿境 · 14% vs 78% 仪式需求断层洞察

03AI 工作流AI WORKFLOW

三层 Prompt 架构 + ComfyUI/SD 标准化生图 + AI 辅助用研 NLP 初筛

眾生鏡 + 共振之靈 + 愿境 三项目实战

支撑能力 SUPPORTING
04交互设计

旅程 → 原型 → 动线 → 信息架构 → 可用性测试全链路 · V1→V4 四轮迭代

05视觉审美

界面 · 品牌视觉系统 · 信息可视化 · 动效 · SD 三代风格迭代体系

06跨学科协作

XCEPT 多线协作 + PolyU 4 人团队 + 港大研究课题

EDUCATION

香港理工大学 多媒体创娱理学硕士(MSc IME)2027 · 四川美术学院 视觉传达设计 BFA · 入选跨媒体艺术工作室(CMS)

WHAT I'M THINKING ABOUT

当 AI 从工具变成协作者,交互范式需要被重新定义。从 Prompt 架构到情感感知,人机协作的边界在持续移动。

在此之外,我关注的另一条线是用计算工具让文化叙事变得可体验。重点不是把它当作滤镜,而是作为可工程化的系统设计;这两条线的交叉点,是我想长期投入的工作方向。

02

作品集总览 / Portfolio Overview

四个项目,串成一条能力线 — 从「用好一个 AI」到「编排一套 AI 系统」

AI 行为可控 → 多模型编排 → 生产协议化 → 用研验证

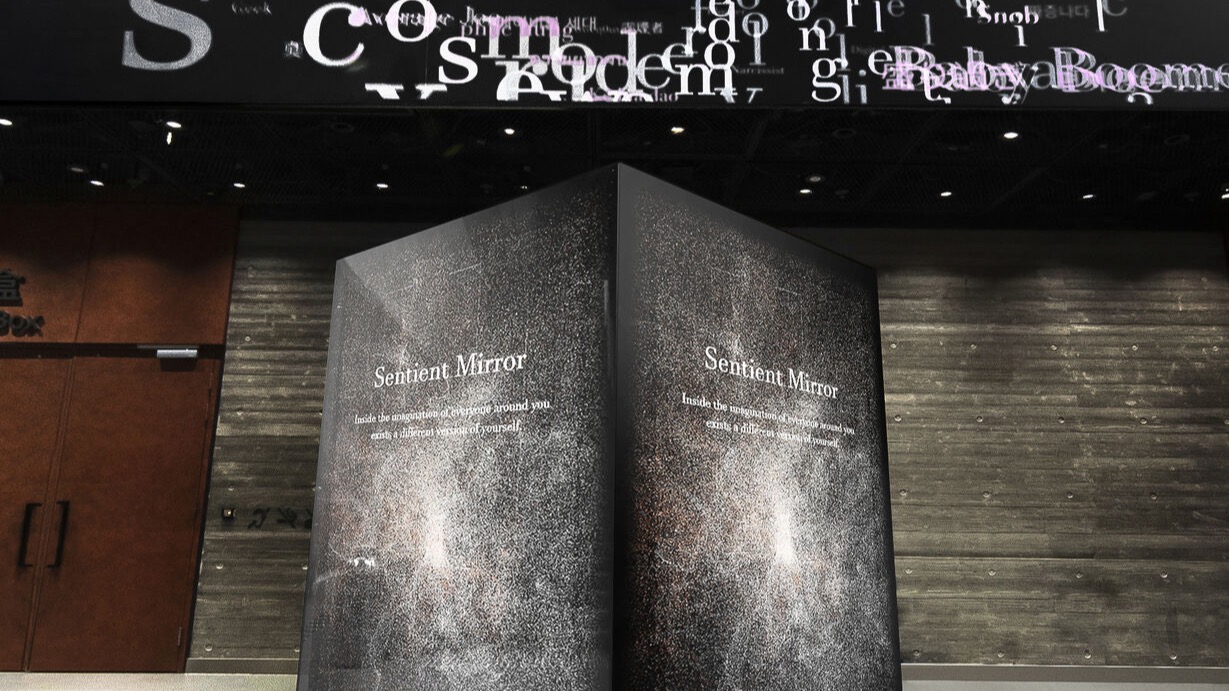
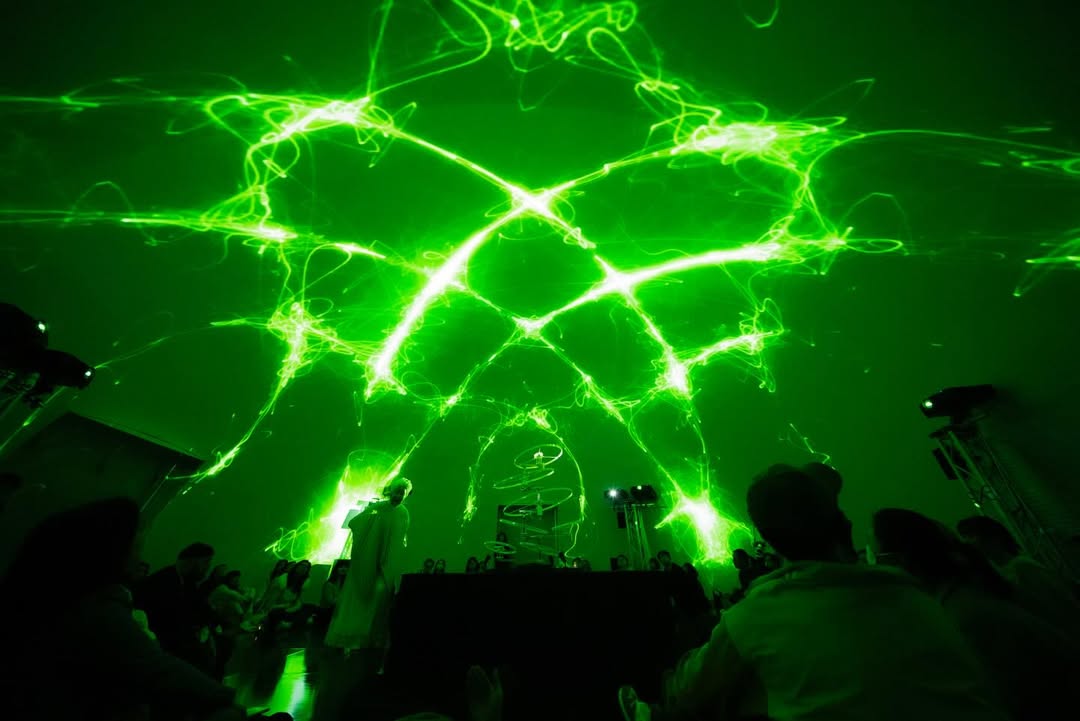
眾生鏡 现场 — UABB 装置 + AI 生成香港建筑材质变换
01 AI 行为可控 / CONTROLLABLE AI

眾生鏡 Sentient Mirror

数据分析驱动 · AI Product System Builder AI 行为参数
AI 行为参数化三层可调权重数据驱动调参
100+
版本化生成视频 · A/B 决策证据
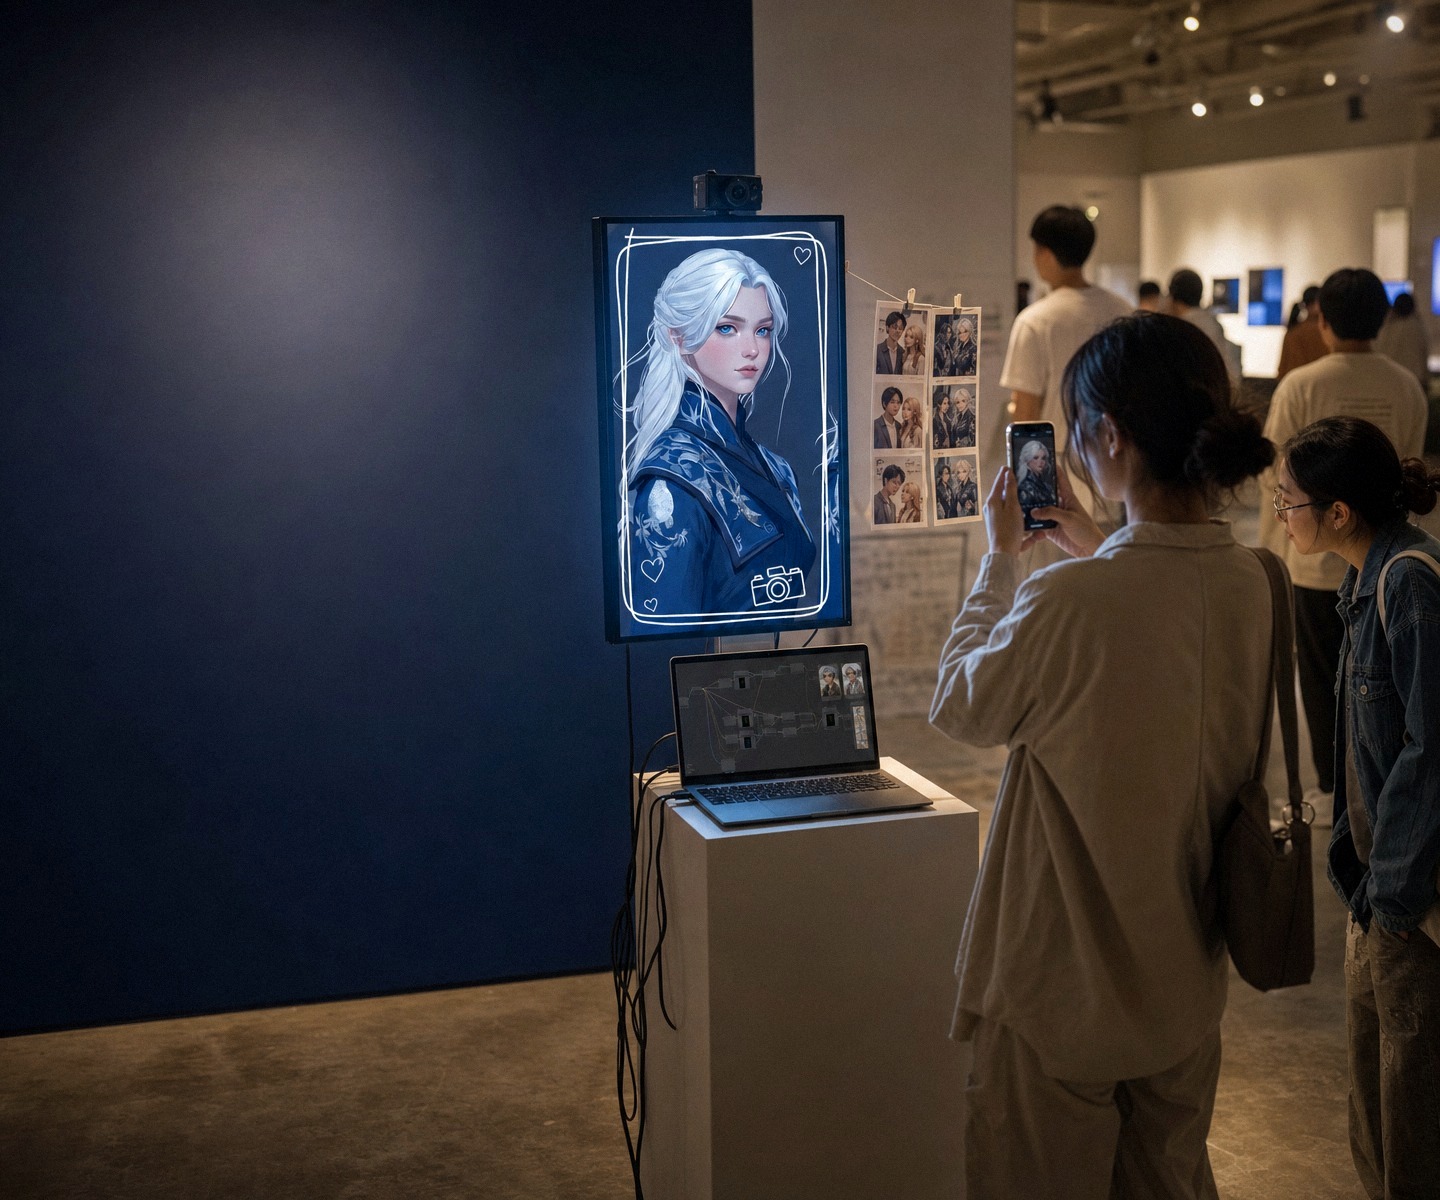
PolyU AI Photobooth 现场 — 多模型编排展台
02 多模型编排 / MULTI-MODEL ORCHESTRATION

PolyU AI Photobooth

系统集成驱动 · AI Full-Stack Designer 多模型 AI 编排
多模型编排HITL 人工介入代码独立落地
6 个 AI
一套系统协同编排的多模型
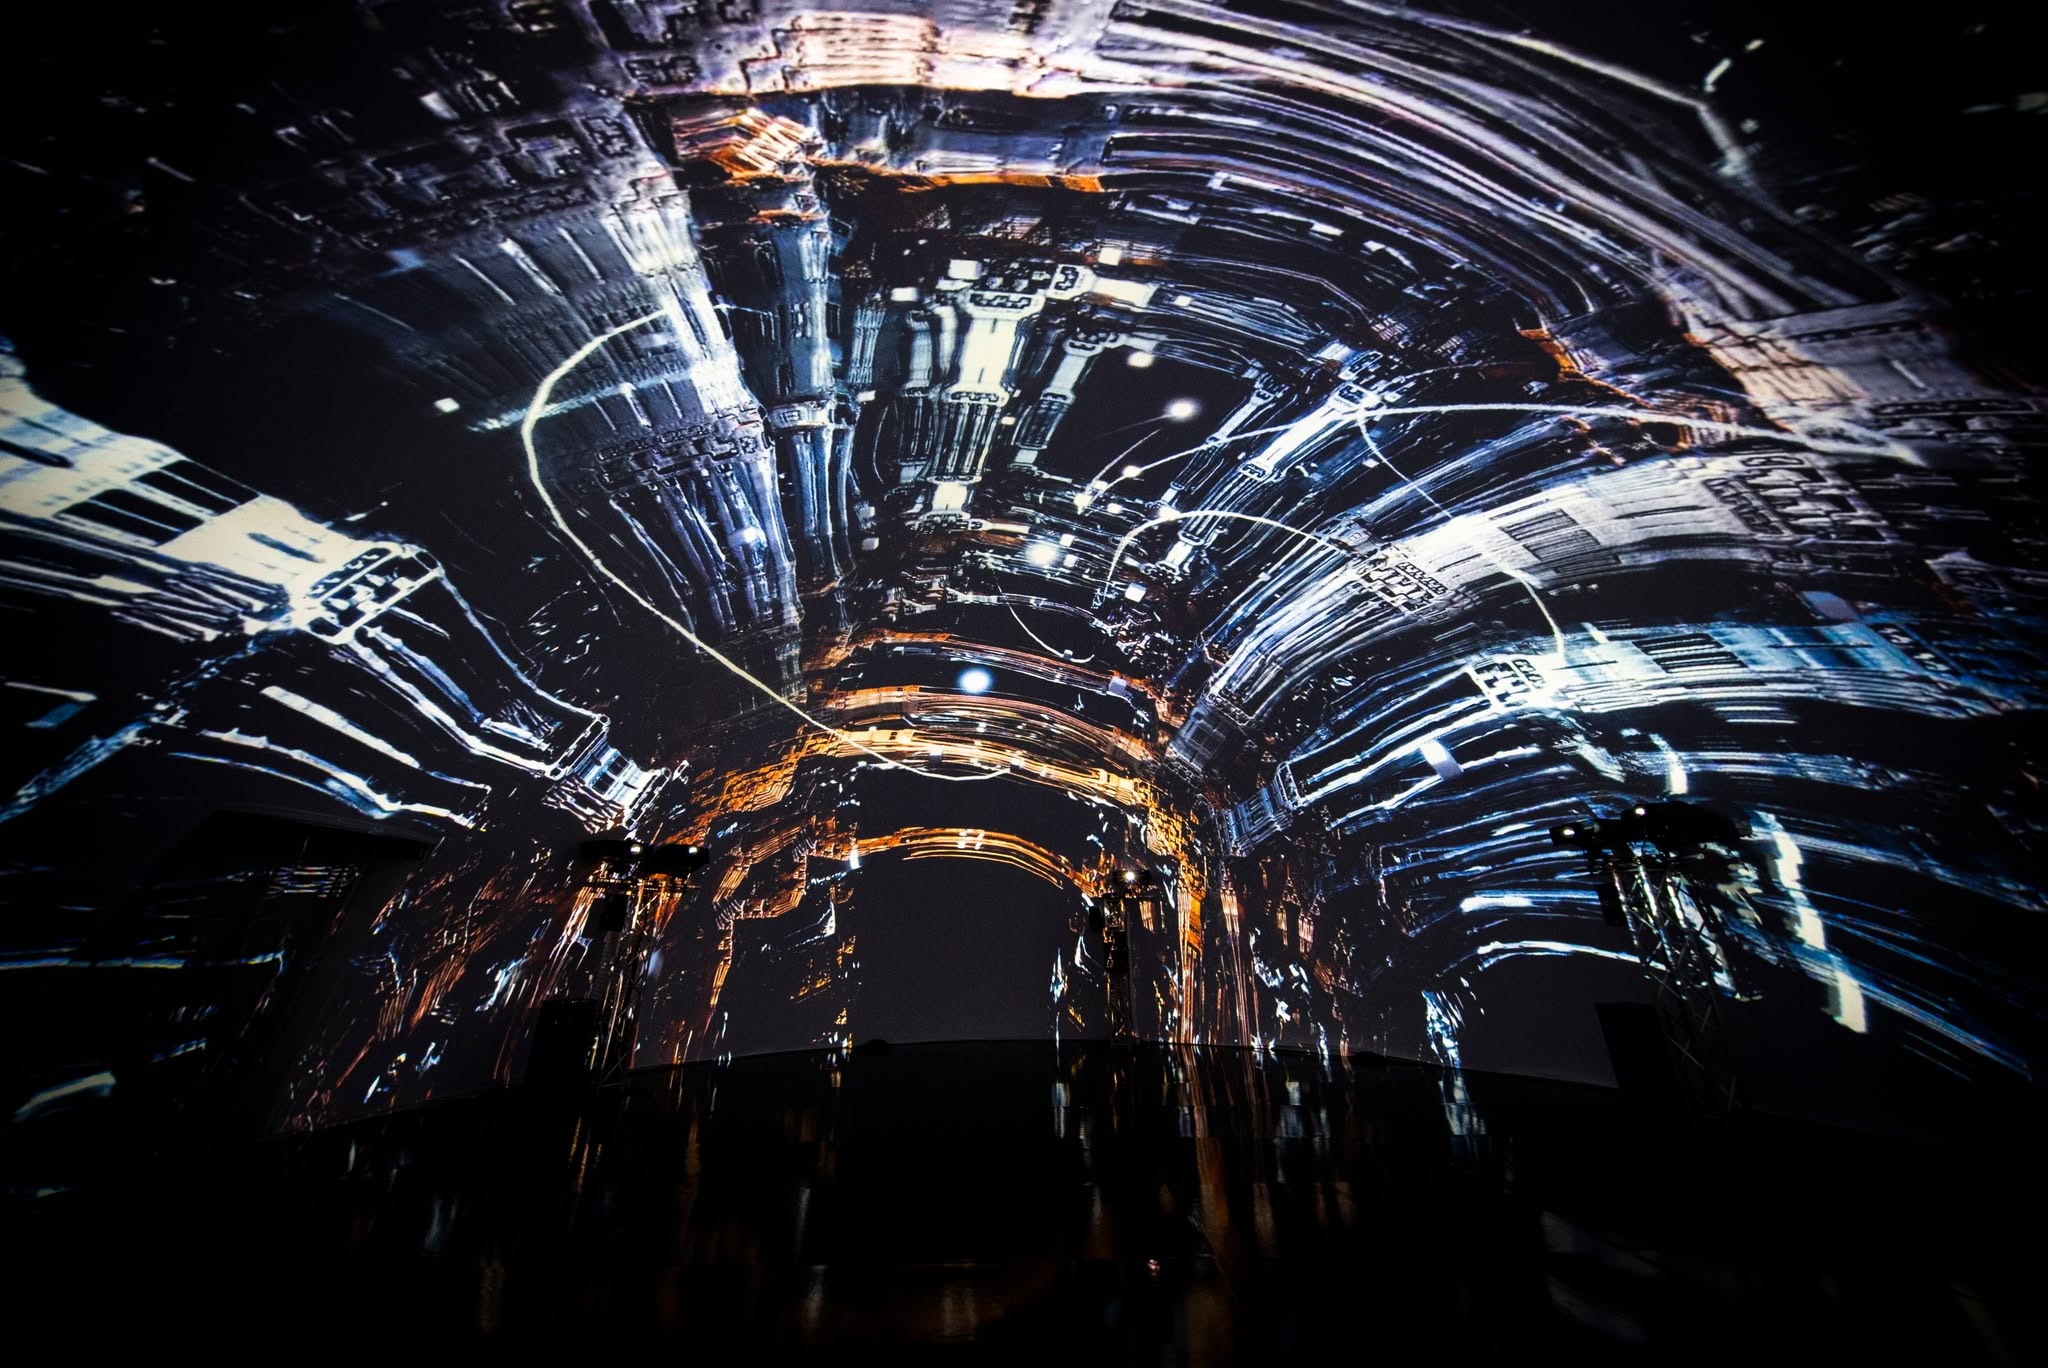
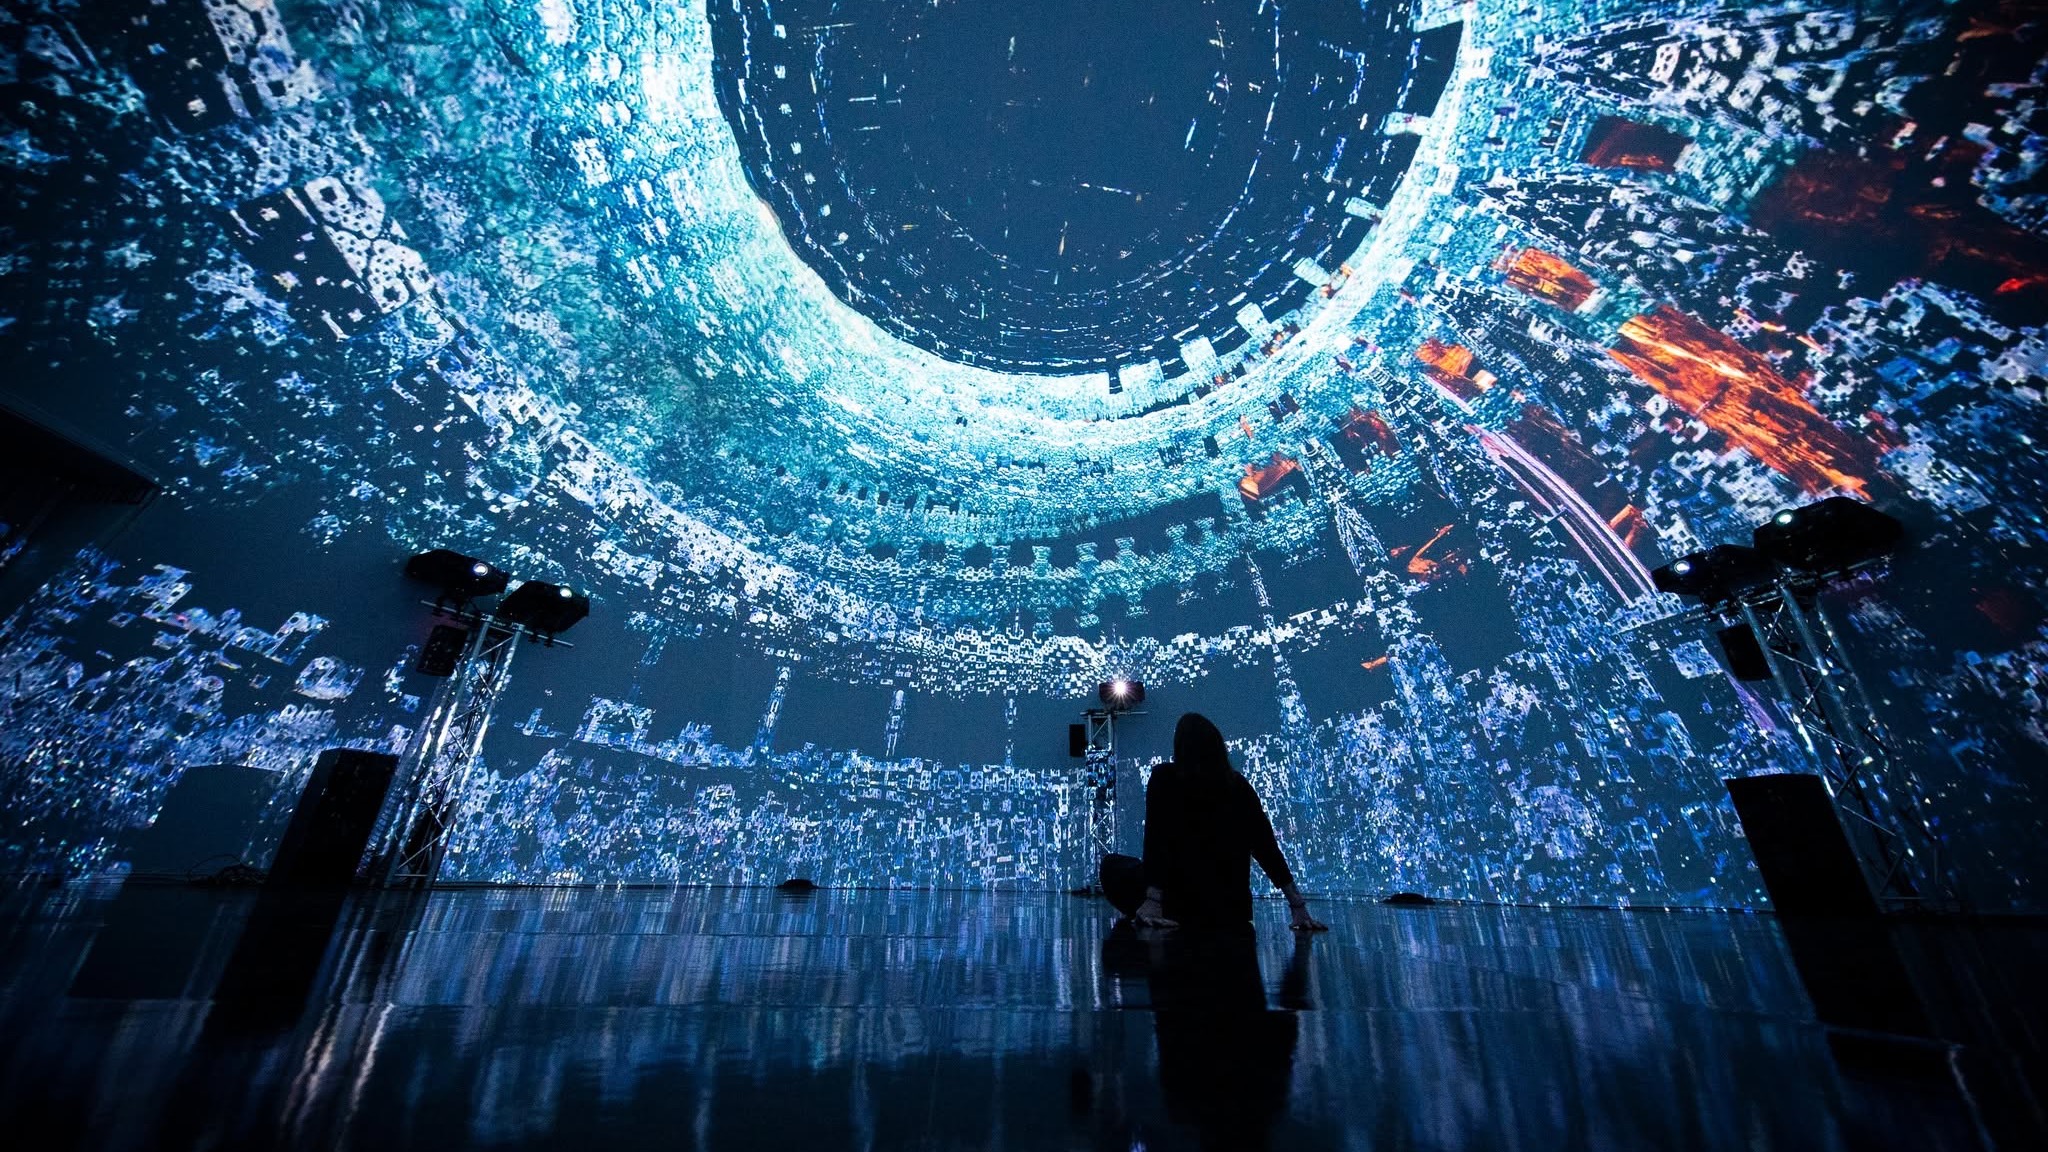
共振之靈 现场 — 穹顶内部沉浸视角
03 生产协议化 / PRODUCTION PROTOCOL

共振之靈 Resonance Aura

难点突破驱动 · Creative Technologist AIGC 内容协议
生产协议化可团队交接4 步 HITL
60 象
一部典籍全数字化生成
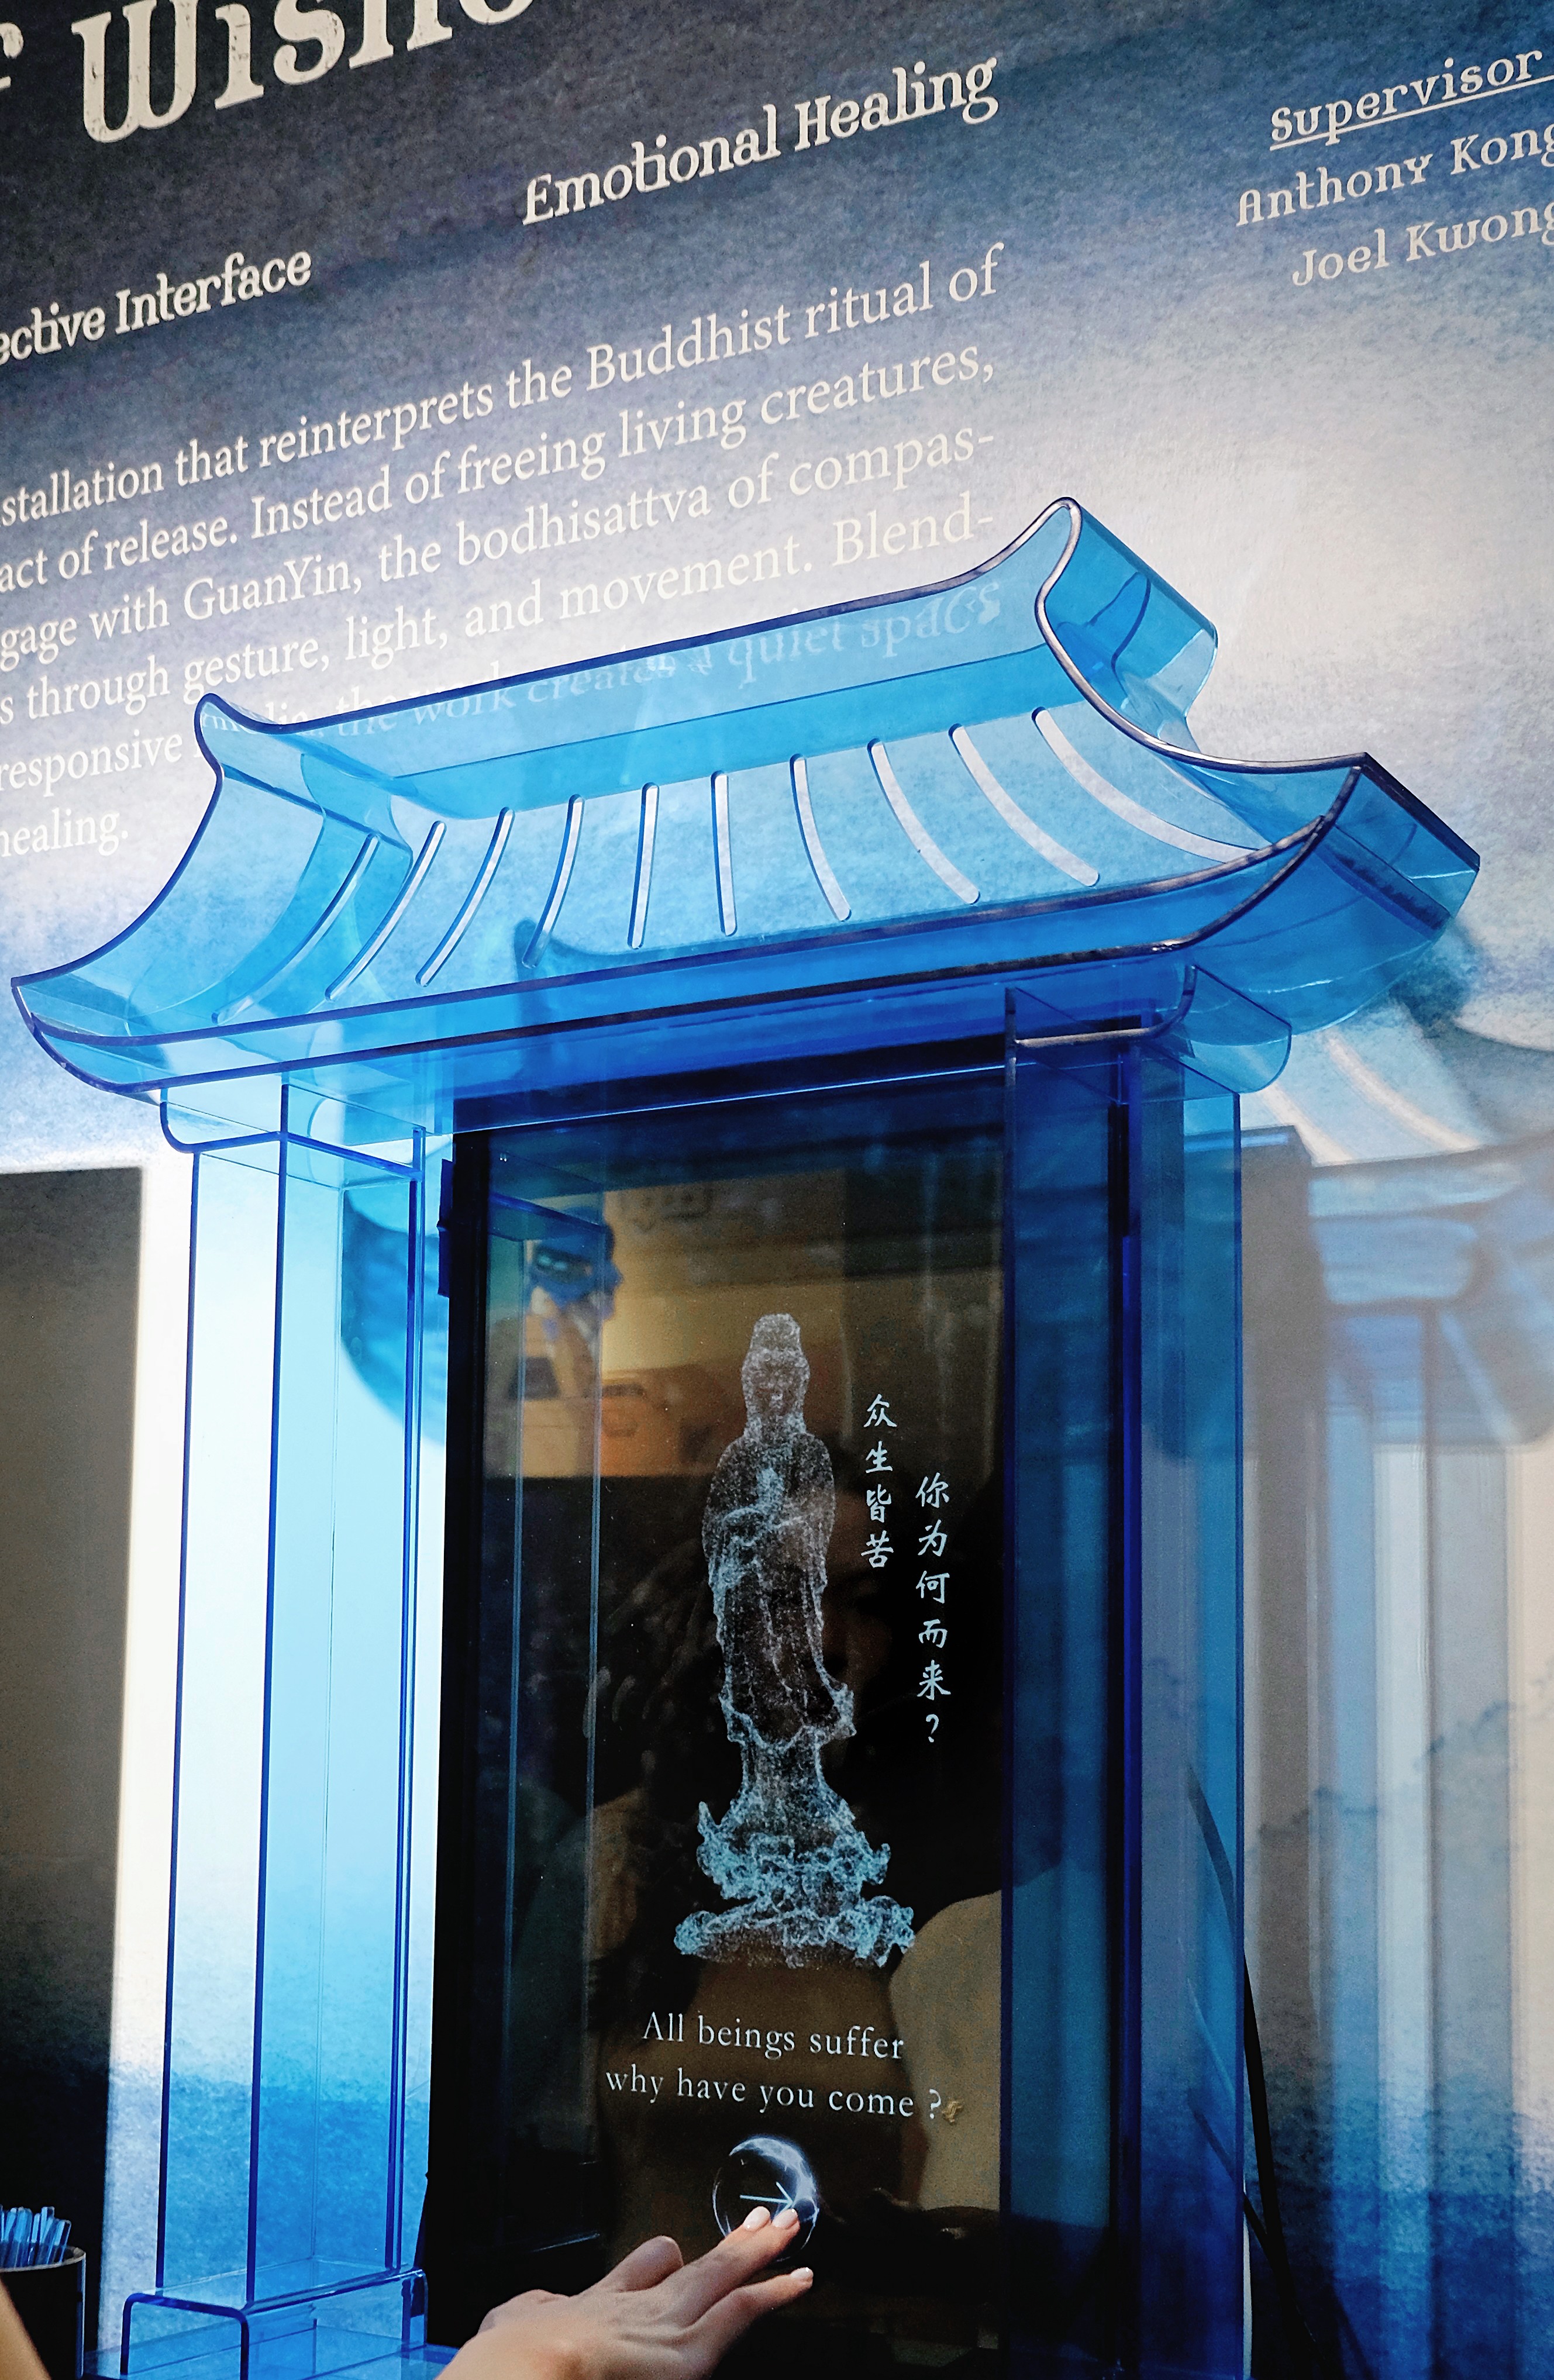
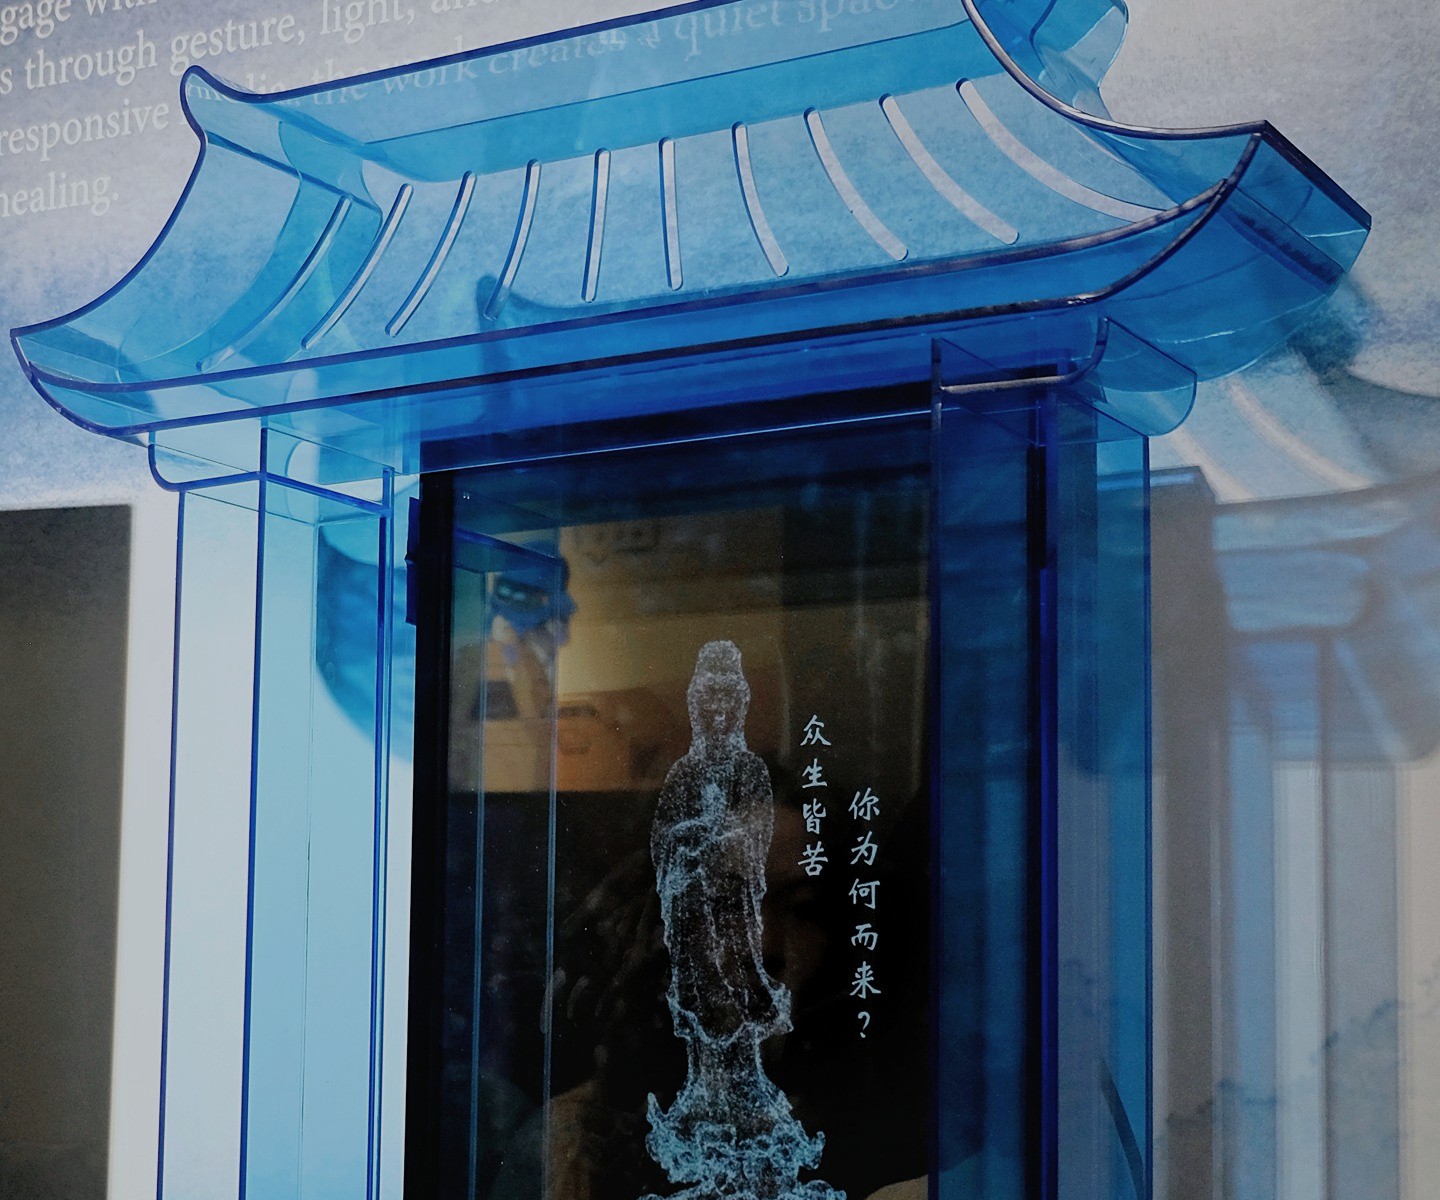
愿境 现场 — 蓝色亚克力龛发光造像
04 用研验证 / RESEARCH VALIDATION

愿境 Realm of Wishes

用户洞察驱动 · Research-Driven Designer 仪式体验混合用研

混合方法用研需求→可验证N=15+90
11/17
用户体验评分 · N=15+90
这条能力线证明

“ 把 AI 从不可控,变成可设计、可编排、可交付的产品系统,再用研究验证它对用户成立。”

03
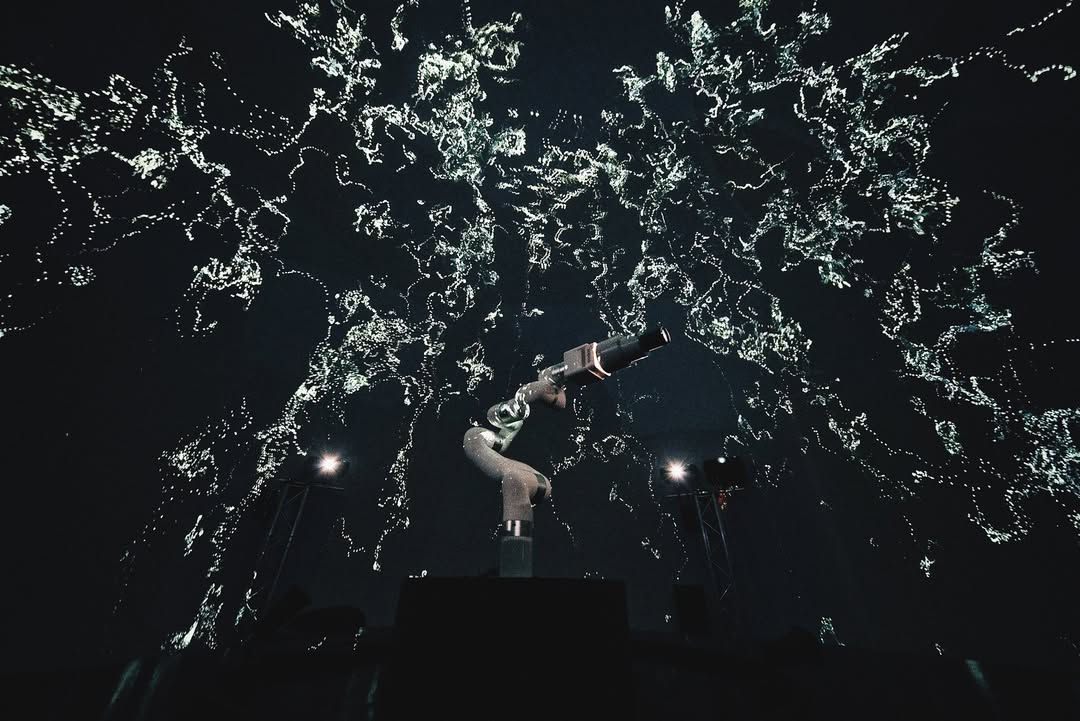
共振之靈主视觉 — 穹顶内部沉浸视角 + AIGC 白描风格 60 象 + 粒子叠加

PROJECT 03 — CREATIVE TECHNOLOGIST · 难点突破驱动

共振之靈 Resonance Aura

我把《推背图》60 象的 AIGC 视觉生产,从「写 Prompt 试错挑可用」的经验性流程,主动升级为可文档化、可团队协作的工程协议 — 让图像跨批次跨场景稳定生成、文化语境一致

60 象 × 6 维
图像学拆成 360 分析单元 — 沉淀为团队可复用的生成协议与视觉规范文档
3 代 · 4 步
v1 学术语义 → v2 视觉元素 → v3 几何降维;HITL 阻断 SD 语义幻觉

核心挑战  跨批次·跨场景·跨实时层文化语境一致——SD 对白描风格反向理解

服务对象  穹顶展现场观众 · 策展团队 · Art / Tech Team(文档 + 组件对接)

项目立足点  图像学 × 唐卡色彩 × 穹顶运动语言 → 可工程化 AI 参数,无现成协议

最终成果  双层架构:AIGC 内容引擎 × TD 实时粒子,color_palette 组件自动打通色板

主导 3 代 SD Prompt 协议 4 步 HITL 阻断 AI 幻觉 首创 几何降维三大法则 自研 color_palette 桥接组件
24
Timeline 2025.09 — 2026.02(≈6 个月)
My Role Creative Technologist & UX System Builder
Team XCEPT × FutureScope 穹顶展策展线
Type 沉浸式穹顶装置(AIGC + SD + TD 实时粒子)

项目概览 / Project Overview

当 AIGC 遇上一本充满视觉异象的文化典籍

共振之靈系统剖面:内容层 ⊂ 交互层 ⊂ 跨系统层 单壳三构造层剖面(S128e E1b 定稿·S129 R4 气质层修:排线改点阵/支座去填色=去面质感制图腔·lime 落交互层+▽测点组=「信号→粒子」交互系统·user 拍板组合);壳体三片构造层 = 内衬内容层(最亮·投影面)/ 中片交互层(粒子虚线·lime)/ 外片跨系统层;spec:六维报告 v1.1 §5/§6「总-分」立论图 + 冷判 artifact b17ac25c(原 6325bd62 已删·台账缩编迁入) 跨系统层 色彩取样桥接 交互层 TD 实时粒子 内容层 SD 白描生成 装置底线 · 观众 位置 / 音频 / 时间 信号
张力 1

内容层

在本项目 60 象 × SD Prompt 协议下,输入纯几何形态比输入语义解读更可控

SD 模型对白描风格有天然的反向理解——让 SD 处理它擅长的几何,把文化语义留在 Visual Logic 字段。

学术语义 → 战争片化 · woodblock print → 60 象黑底反相 · 2 次系统性失败

张力 2

交互层

既要实时响应观众,又要让 AI 的生成行为始终落在策展可接受的范围内

穹顶是实时交互装置——60 象不是循环播放的固定视频,而要随观众的位置 / 音频 / 时间三类信号连续驱动粒子。

位置 / 音频 / 时间 · 三信号 → 粒子连续驱动

张力 3

跨系统层

需要一个能把 AIGC 实际输出色彩自动取样、注入 TD 渐变纹理的桥接组件

内容层用唐卡色板作为 AI 输出的色彩约束,但 TD 粒子系统的颜色映射如果靠人手另配,两层在长时间迭代下会出现风格漂移。

唐卡色板 → 自动取样 → TD 渐变纹理
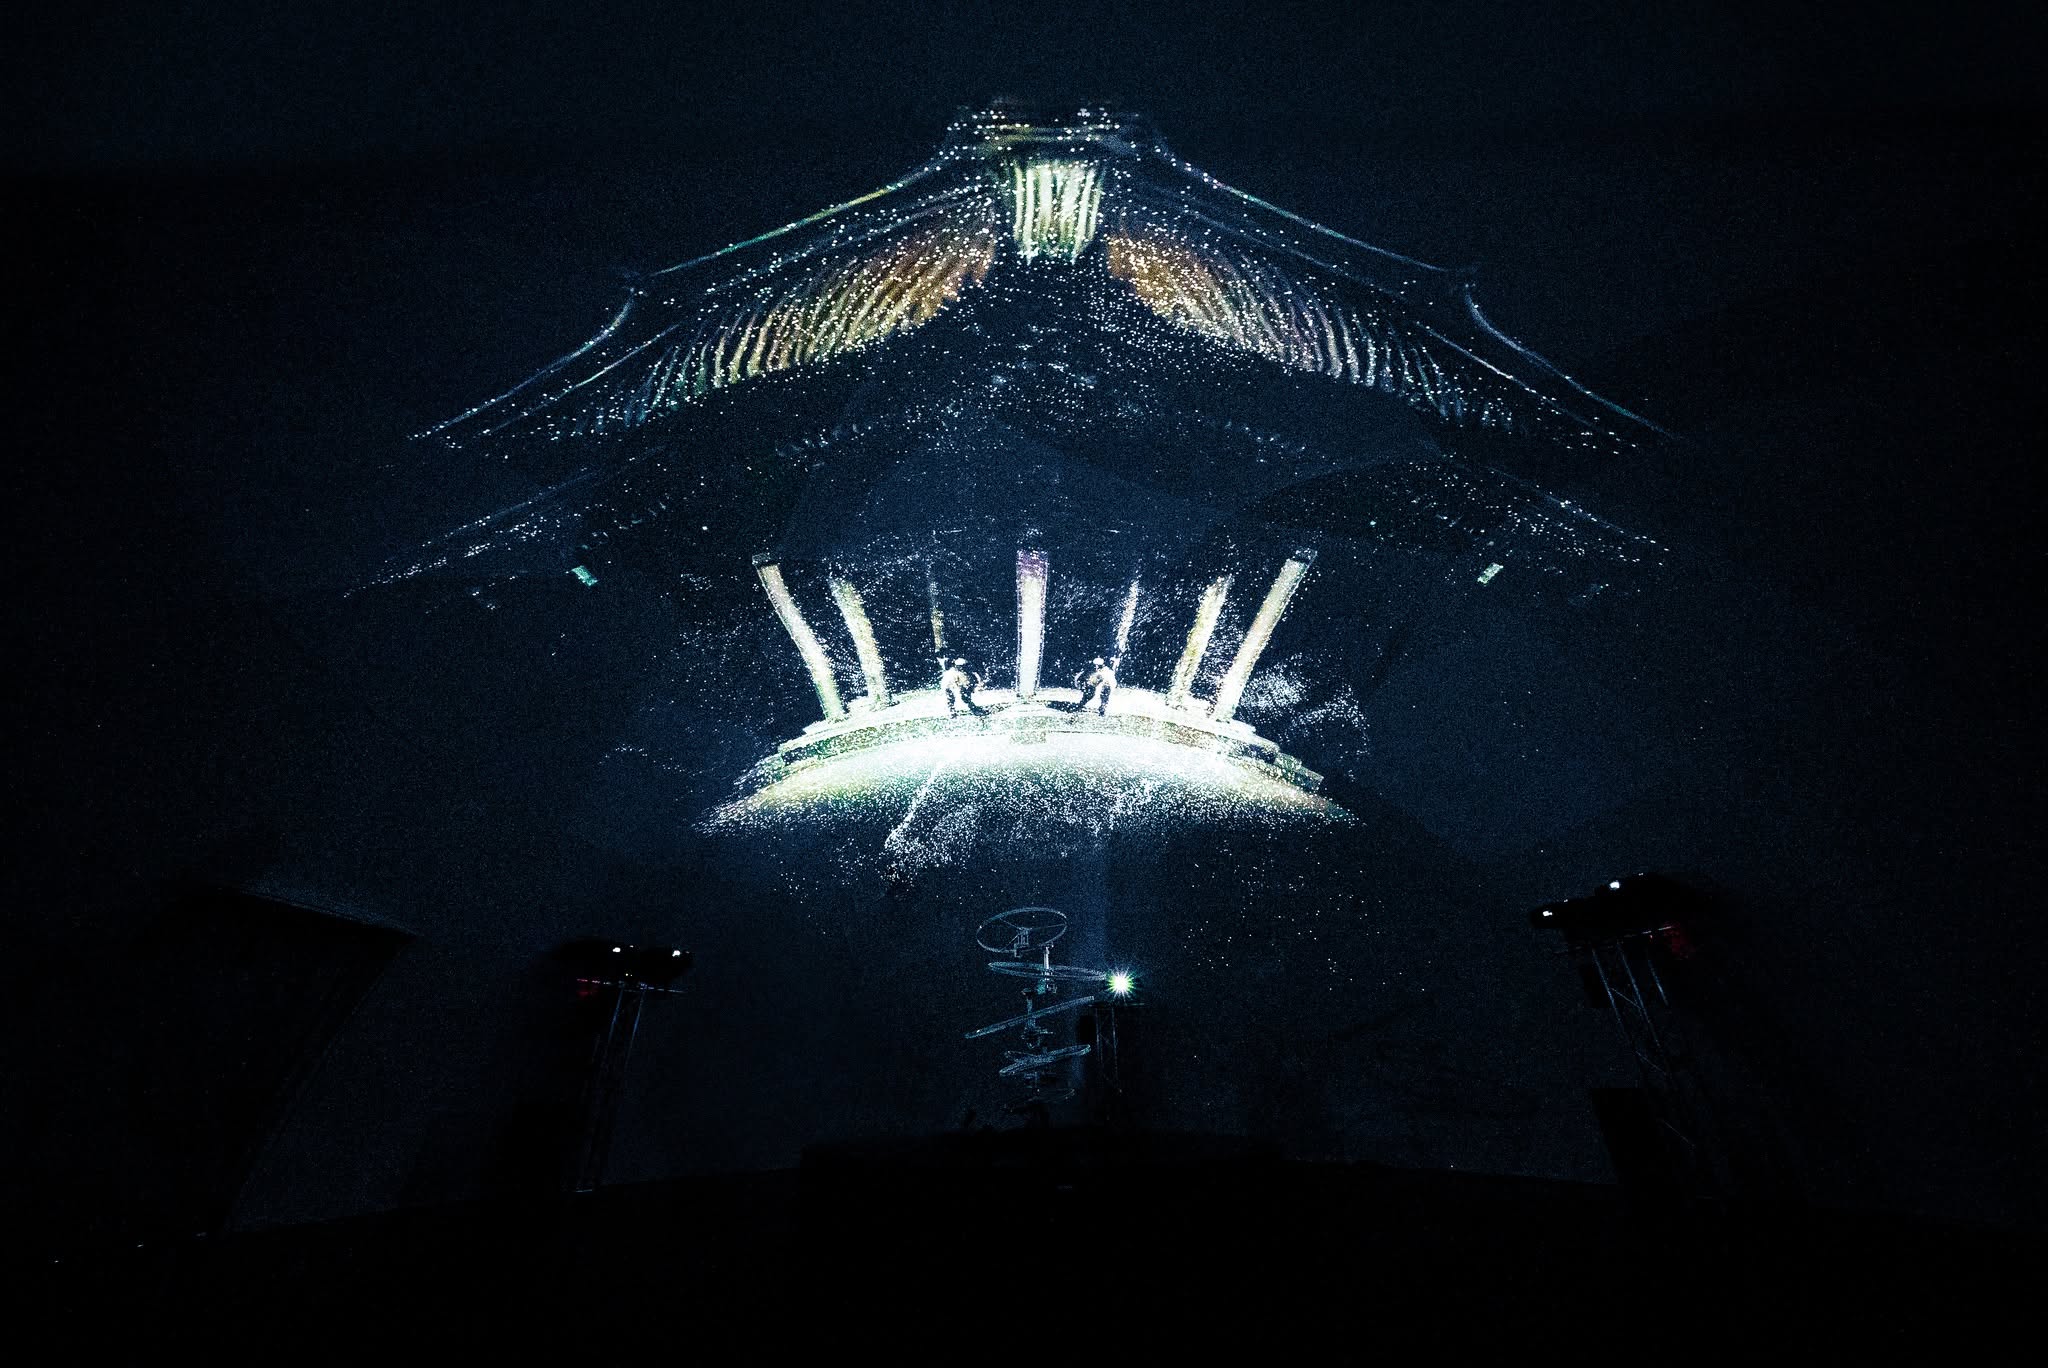
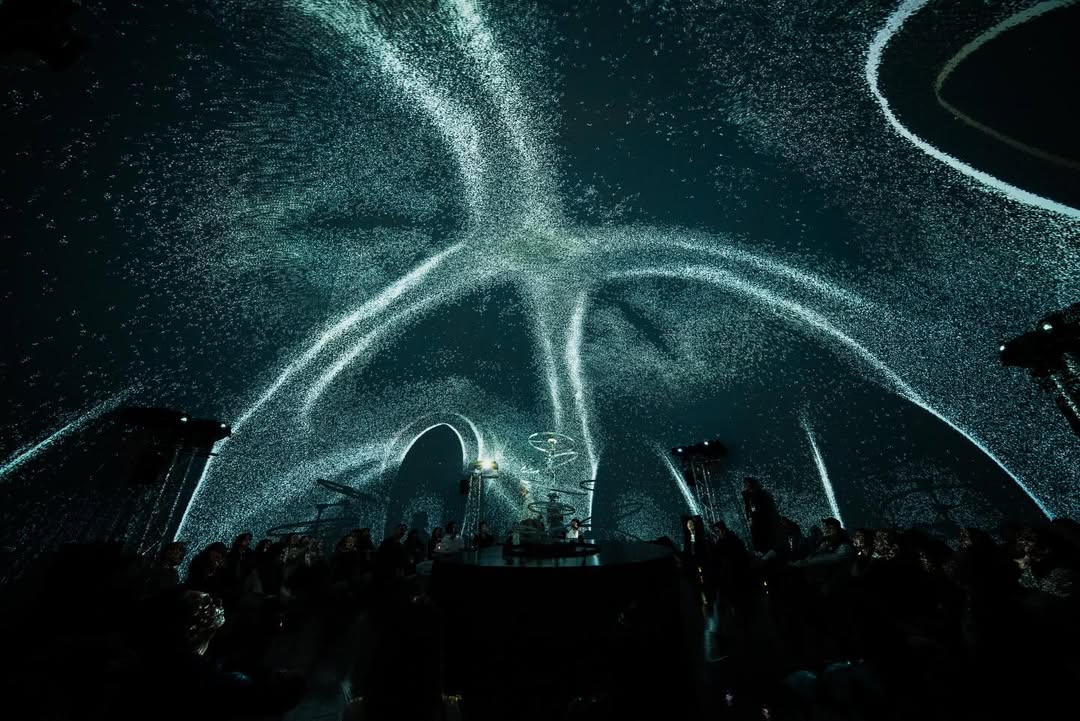
穹顶现场 — 60 象文化典籍内容球面投影(建筑/典籍意象)+ 观众沉浸视角

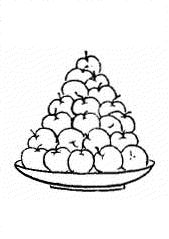
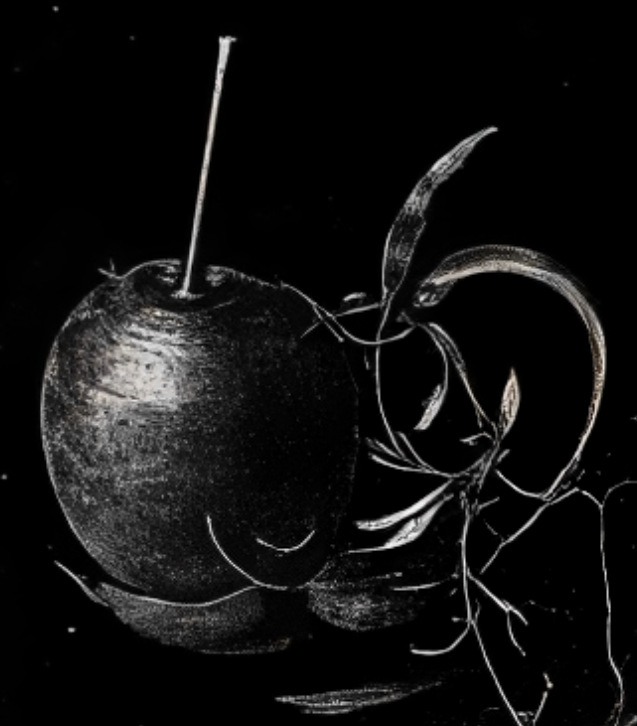
原典 · Image A

推背图 第二象 盘中果 原典(公版低清线描)
→

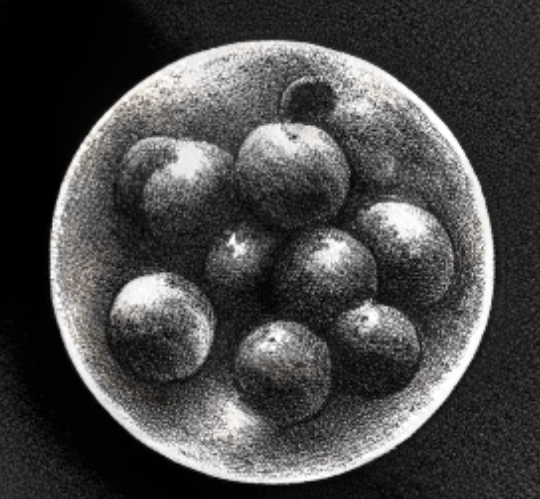
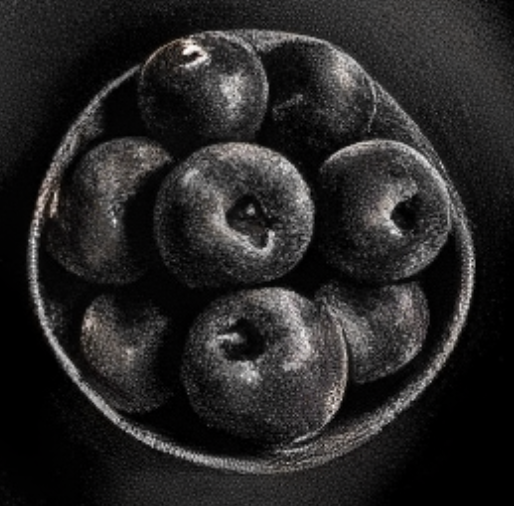
SD 白描 · Image B

SD 几何降维白描生成(过程版)盘中果
内容层 · 实证

几何降维:盘中果 → stack of circles —— 生成图保留原典「一盘圆果」结构

策展团队真正想要的不是「生成好看的图」,而是「让 60 象在跨批次、跨场景、跨实时交互层都保持文化语境一致」——这要求把文化典籍的系统化转译当作一个工程问题来解决,而不是当作一个更花哨的滤镜来使用。
25

探索研究 / Research Study

60 象 × 6 维 = 360 个结构化分析单元

研究对象是 AI 模型的图像理解机制——v1「学术语义路径」生成可用率不足 10%(AI 把「柴火」画成大树、「枯木旁的人」画成尸体),v1 实测撞到这条边界后,我把研究目标重定为「先解码模型理解图像的机制,再设计 Prompt 协议」,而非继续在 Prompt 词面上试错。

研究要回答的核心问题三问 / Core research questions

  1. 模型先验偏差到底分布在哪些词汇 / 概念组合上?
  2. 如何把《推背图》的视觉异象(违反物理规律的元素、悬浮、比例失调)翻译成 AI 可解析的几何语言?
  3. 文化色彩约束(唐卡色板)能否作为跨系统视觉一致性的工程接口?

研究底层方法论参考了 Doyle (2019) 价值驱动设计框架——从文化价值层级逐层推导技术参数,而非直接从技术端试错。这正是系统化分析的理论支撑:先理解图像承载的文化价值结构,再将其翻译为 AI 可解析的工程语言。

4 个核心洞察

洞察 1在本项目 SD Prompt 工程下,输入几何形态比输入语义解读更可控

洞察 2风格标签的训练集含义可能与设计意图相反——woodblock print 触发黑底反相

洞察 3多物体相互关系是 SD 的盲区,必须用空间隔离词显式指令

洞察 4跨系统视觉一致性必须靠工程组件而非人工规范

框架可视化 / Framework schema:

整体构图人物特征肢体动作关键器物自然环境视觉异象
# QUALITATIVE SCHEMA
TOPOLOGICAL MATRIX · 6维×60象=360
SEC.01  图像学层
DIM MAPPING
多维映射矩阵 · 单元提取重构
360
SEC.02  视觉符号层
120+
人物
动物
植物
环境
建筑
器物
抽象
SEC.03  色彩规范层
TOKEN MAPPING · 唐卡源色板
氧化红
朱砂橙
金
亮黄
橄榄金
矿绿
青蓝
蓝

三条并行研究主线:

①Analysis Framework

6 维结构化分析框架

逐象拆解(整体构图 / 人物特征 / 肢体动作 / 关键器物 / 自然环境 / 视觉异象),产出 360 个分析单元 + 60 套关键词标签。

②Symbol Lexicon

可计算的视觉语义系统

构建 120+ 视觉符号词典(7 大类:人物 / 动物 / 植物 / 环境 / 建筑 / 器物 / 抽象结构)+ 视觉语法模型(符号 + 构图关系 = 象征语义)。

③Color Tokens

唐卡色板 = 跨系统一致性的工程接口

提取唐卡色板规范(从源画面取样的多层渐变 — 暖色系(氧化红→橙→金黄)为主体 + 末端青蓝冷调),作为 AIGC 内容层与 TD 交互层共享的视觉约束接口。

26

设计策略 / Design Strategy

三条反共识策略

研究告诉我两件事:在本项目 SD Prompt 工程下,输入纯几何形态比输入语义解读更可控;跨系统视觉一致性需要靠工程组件承接,而不是规范文档。这两条洞察可以走完全不同的方案路径——策略层的工作是在这些路径里选一条主道,并明确放弃哪些。

①Protocol over Heuristics

协议工程化

通过几何降维 + 去语义化 + 强制风格锁定的三大法则与 4 步 HITL 工作流,改变 AI 模型对白描风格的反向理解,达成 60 象跨批次生成的文化语境一致性。

放弃 ✕ 经验性 Prompt 试错 ✕ 学术语义描述(v1 失败) ✕ woodblock print(v2 失败) ✕ 单纯加法 Positive 引导

②反共识技术决策

放弃 LoRA,选择可迭代协议

通过主动放弃已训练的专属 LoRA、改为可迭代的 Prompt 协议 + Style Header 硬编码,改变风格控制权从「绑死在模型权重」到「保留在人手里、可热更新」,达成展览方多元化需求与稳定输出的兼容。

放弃 ✕ 固定单一风格 LoRA — 团队评审中识别为「展览方需求多元化下的反向约束」

③Component over Specification

组件化替代规范文档

通过自研颜色桥接内部组件(AIGC 图像颜色取样 → 自动转换 → TD 粒子色彩映射的完整管道),改变靠规范文档约束跨系统一致性的传统方式,达成唐卡色板从 AIGC 内容层自动延伸为 TD 实时粒子色彩约束。

放弃 ✕ PDF 规范文档手动配色 ✕ K-means 自动聚类(丢失渐变) ✕ AI 自动生成 palette(无渐变顺序)
共振 · 策略推导映射图 三层推导:上层 p06 四项研究洞察加第五节点团队评审输入(虚线区分来源),经映射线收敛到中层三条策略主线(协议工程化 源自①②③ / 组件化替代规范 源自④ / 放弃 LoRA 选协议 源自⑤评审输入),再各自分叉为下层双支取舍(实线直行 = 保留项 · 虚线岔出 = 放弃项)。§T 映射 · V3 · 源: p06 洞察 1-4 + 团队评审 → 本页 3 策略。 STRATEGY DERIVATION · 策略推导 4 洞察 + 评审 → 3 策略 → 取舍 ① 核心洞察 / INSIGHTS ① 几何优于语义 Prompt 实测 ② 风格标签反转 woodblock 反相 ③ 多物体盲区 需空间隔离词 ④ 组件承接一致 规范文档失效 ⑤ 需求多元化 评审输入 / REVIEW ② 策略主线 / STRATEGIES 源自 ①②③ 源自 ④ 源自 ⑤ 协议工程化 组件化替代规范 放弃 LoRA 选协议 Protocol over Heuristics Component over Spec Iterable Protocol ③ 方案取舍 / TRADE-OFFS 保留 / KEEP ✓ 几何降维三法则 ✓ 4 步 HITL 工作流 放弃 / DROP ✕ 经验试错 ✕ 学术语义 · v1 失败 ✕ woodblock · v2 失败 ✕ 加法引导 保留 / KEEP ✓ 颜色桥接组件管道 放弃 / DROP ✕ PDF 手动配色 ✕ K-means 聚类 ✕ AI palette 保留 / KEEP ✓ 可迭代 Prompt 协议 ✓ Style Header 热更新 放弃 / DROP ✕ 固定单一风格 LoRA

LoRA 权重、规范文档、经验试错——三条「省事的默认」都被反向验证会锁死迭代空间。三条策略共享一个反共识内核:把风格控制权留在可迭代的工程组件里。

27
方案展示 I · 难点突破驱动 / Solution I · Breakthrough-Driven

SD Prompt 3 代协议 + 4 步 HITL 工作流

3 代迭代 · 每一代推翻一个旧判断
共振 · 4 步 HITL 人机协作闭环(Vision-LLM 几何拆解 → Human 审核 → SD 渲染 → Gemini 质检 → 闭环回审) 4 步人机协作工作流:① Vision-LLM 几何化拆解(AI)→ ② Human 审核 Visual Logic 字段(人工·最早阻断点·5 秒/张)→ ③ SD 渲染批量生成(AI)→ ④ Gemini 视觉质检(AI);质检不过回 ② 人工复审形成 HITL 迭代闭环。①④ 同源候选模型:Gemini 3.1-pro(选中)/ GPT 5 / Claude opus 4.6 / Doubao-Seed-2.0 / Kimi-k2.5。产出 60 象跨批次文化语境一致。spec: §T6.c · M9+M5 · B80+B86 · 4-step HITL loop HITL WORKFLOW · 人机协作闭环 4 步 · AI×3 / 人×1 ① AI Vision-LLM 几何化拆解 ② ★ 人工 Human 审核 Visual Logic 字段 · 5 秒/张 ③ AI SD 渲染 批量生成 ④ AI Gemini 视觉质检 质检不过 → 回 ② 人工复审 · HITL 迭代闭环 ①④ 同源候选 Gemini 3.1-pro ✓ GPT 5 Claude opus 4.6 Doubao-Seed-2.0 Kimi-k2.5 60 象 · 跨批次文化语境一致
v1.0 语义路径生成结果 — 反相深色调、战争片化(失败)

v1.0 — 语义解读路径 失败

用「战乱」「皇权」等学术语义描述 → SD 生成战争废墟与悲伤表情,完全偏离白描风格。教训:让模型承担语义解读不可控;可控路径是输入纯几何事实。

v2.0 woodblock print 生成结果 — 黑底白线反相(失败)

v2.0 — 视觉元素翻译 + woodblock print 失败

woodblock print 在 SD 训练集中大量对应暗黑版画,60 象全部触发黑底白线反相。教训:风格标签的训练集含义可能与设计意图相反。

v3.0 几何降维生成结果 — 白底白描稳定(成功)

v3.0 Final — 几何降维 + 强制风格锁定 成功

三大机制同时生效:① 风格降维(baimiao + 强制白底高权重)② 几何降维 + 去语义化(纯物理形态描述)③ 针对性负面预判(每类对象独立 Negative)。60 象全集稳定批量生成。

①关键决策溯源

路径选择训练了 LoRA 但主动放弃——展览方需求多元化与固定风格不兼容
对象描述法学术语义 → 视觉元素 → 纯几何降维(stack of circles)
HITL 介入点选 Visual Logic 阶段——5 秒/张扫读成本,最早阻断 AI 幻觉

②三级设计分层

风格锁定层Style Header → 等效 Brand Token
内容翻译层Object Description → 等效 Component Token
偏差对抗层Negative Constraints → 等效 Context Token

③迁移性结论

把 AI 行为参数当作设计系统的 Token 来管理

28
方案展示 II · 测试迭代 / Solution II · Test & Iteration

TouchDesigner 三模式粒子 × AIGC→TD 颜色桥接:让实时交互与 AI 内容在穹顶尺度上共振

①架构层 v3→v15+ × 子版本层 dome .v3→.64

v3–v8

POP Attractor 早期 触发重构

单一吸引器 + 单层粒子系统。Art Team 反馈视觉语言单薄 → 触发「3 模式架构」重构;穹顶尺度也暴露出呈现稳定性问题。

v8–v15

三模式架构成立 部分验证

Attractor / XY Interact / Audio-Reactive 三模式分离,独立调参可行;穹顶尺度下的呈现仍需一轮几何适配才稳定 → 触发终版几何链路。

v15+

终版 dome .64 + 颜色桥接 稳定

3 模式 + 穹顶几何适配 + 自研颜色桥接组件(v1.0→v1.4)。100+ 版本化 .toe 文件 + 多份大型 .mov 演示视频留存。

CrashAutoSave 多次触发(3D Reaction Diffusion v3→v8 / InteractiveSphere.15 / Particle Attractors 31:53),印证项目实际工程节奏——高强度实时操作中系统崩溃后通过自动保存恢复关键节点。

②3 模式 × 3 种「人与宇宙关系」隐喻

能量吸引场

观众进入空间时粒子向其聚集

被吸引 · Position (x,y,d)

位置力场

移动轨迹直接改变粒子流向

主动影响 · Position + angle

音频映射

音乐频段驱动粒子振幅

声音共鸣 · Audio bands

能量吸引场 — 粒子向观众聚拢的穹顶实拍
位置力场 — 观众移动轨迹驱动粒子流向的穹顶实拍
音频映射 — 音乐频段驱动粒子振幅的穹顶实拍(Chladni 图样)

3 模式粒子 · 穹顶实拍对照

③AIGC→TD 颜色桥接 · 自研内部组件 v1.0→v1.4

唐卡色板在 TD 层人手另配会漂移。自研自动化管道:参考图 → ChatGPT Vision 颜色采样 → 格式转换 → Ramp TOP 色彩映射 → 粒子视觉系统。

v1.0→v1.1

空格→逗号分隔,修复 Ramp 无法识别问题

v1.1→v1.2

0-255→0-1 浮点,修复 Ramp TOP 全白

v1.2→v1.3

7 stops→10-12 stops,渐变更自然

v1.3→v1.4

均匀采样→结构感知采样,贴近参考图

100+
版本化 .toe 文件
3 模式
粒子交互架构 · 人-宇宙隐喻
4 轮
颜色桥接迭代
29

视觉系统 / Visual System

视觉系统不在风格,在协议 — Style Header × Visual Logic × HITL 节奏的三层契约

P.5 讲三代 Prompt 迭代「为什么放弃 LoRA、放弃语义解读」,这一页讲协议层稳定下来后长什么样——把 60 象跨批次的视觉一致性拆成 5 个可文档化的子协议:Schema / 色板 / Visual Logic 字段 / 数学化概念框架 / HITL 工序。每一条都是给「下一个接手的人」准备的设计 Token,而不是写给 AI 模型的一次性试错口令。

5 子协议 · 每一条都是可文档化的 Token

①Schema

SD Prompt 三层结构

三层结构(Style Header / Object Description / Negative Constraints)映射设计系统的 Brand / Component / Context Token 分层逻辑——把 AI 行为参数当作设计 Token 来管理。三层逐项拆解见右图 Prompt Schema 映射。

②Palette

唐卡三色规范 · 主体 / 点缀 / 强调

从源唐卡画面取样的多层渐变色板(暖色系(氧化红→橙→金黄)为主体 + 末端青蓝冷调,具体配比因项目资产保留)— 用 color_palette_generator.tox 自研工具完成 AIGC 图像颜色取样 → 自动转换 → TouchDesigner 粒子色彩约束的完整管道。放弃:K-means 自动聚类(丢失渐变顺序)/ AI 自动生成 palette(无文化层级语义)。
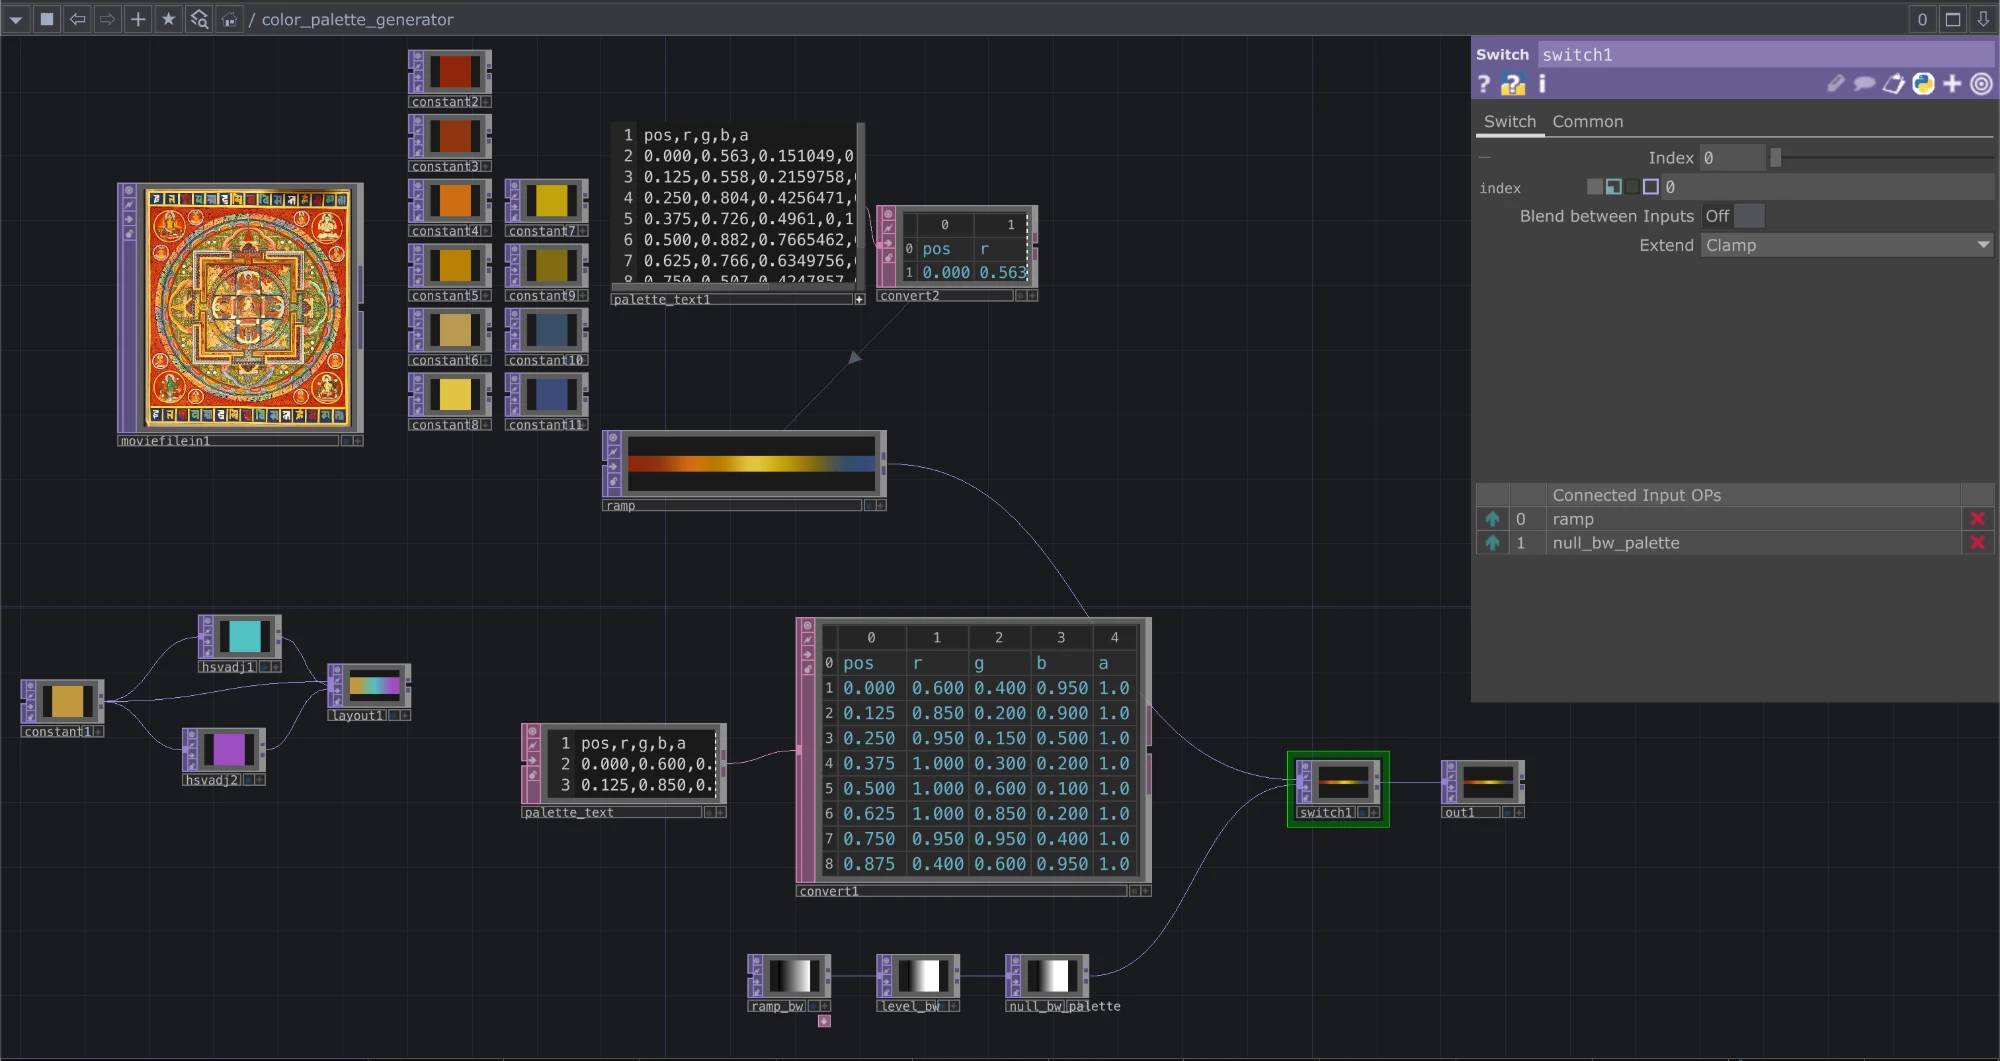
color_palette_generator.tox 插件内部色板 — 真实取样色板 + Ramp TOP 渐变
color_palette_generator.tox 插件内部色板 · Ramp TOP 渐变(具体配比因项目资产保留)

③Field Spec

Visual Logic 字段规范

Vision-LLM 几何拆解结果的标准化字段 — shape / count / arrangement / orientation / relative_position。HITL Step 2 的人工审核界面字段,5 秒/张扫读成本,把人工最早阻断 AI 幻觉的介入点协议化为可文档化结构——而不是事后挑选生成结果。

④Frame

数学化的视觉概念框架

策展方原始 brief 是「《推背图》60 象」抽象文化命题。工程上借鉴河图洛书数学化思维(圆点数量 / 拓扑排布 / 阴阳计数)将其转译为生成约束,让 SD 处理它擅长的几何形态——而不是去描述「中华文化哲学」让模型反向理解。设计原则:把文化语义留在 Visual Logic 字段,把视觉指令留给纯几何。

§T13 9宫格(B111) + §T9.b · V1 · M4+M0 · 共振 数学化网格 — 人话主标「方位×数列→几何生成约束」+ 洛书幻方(和=15)/河图模5 mono 副标(典籍名仅副标·避 §5 禁串);3×3 幻方填 1-9 中心5焦点 + 四向方位-元素-能量 + 右侧→几何约束派生;苔光 token grid=--c-project / 焦点+和15=--c-accent 方位 × 数列 → 几何生成约束 洛书幻方 · 行 / 列 / 对角和 = 15 · 河图模 5 同余 南 · 火 · 阳 ↑ 北 · 水 · 阴 ↓ 东木 ↗ 西金 ↘ 492 357 816 → 几何生成约束 · 圆点数量 · 拓扑排布 · 阴阳计数 喂 SD 几何 · 非语义

⑤Workflow

4 步 HITL 工作流

Step 1 Gemini 几何拆解 → Step 2 ★ Human 审核 Visual Logic(最早阻断点) → Step 3 SD 渲染批量生成 → Step 4 Gemini 视觉质检。Step 1 + Step 4 候选评估同源(Gemini ✓ / GPT-4V / Claude 3.5 / 豆包 / Qwen-VL),两任务共选一模型 — model selection engineering。

Prompt Schema · 抽象 ↔ 具体映射

[Pipeline] Data Transform [Core] Feature Extraction [Base] Anchor Protocol
[L3] CONTEXT_TOKEN
WEIGHT 0.26

Negative Constraints 偏差对抗层

> neg: realism, war, black-bg
[L2] COMPONENT_TOKEN
WEIGHT 0.26–0.48

Object Description 内容层 · 几何降维

> stack of circles, top-down
[L1] BRAND_TOKEN
WEIGHT 0.26–0.48

Style Header 风格锁定层

> baimiao, white bg :1.4
WEIGHTS = per-set 矩阵采样 · n=34 sets · L3 固定 0.26 · L1 / L2 变动 0.26–0.48

协议化的工程价值

可文档化

5 子协议都能形成团队内可对接的文档,下一个接手的人不用重走 3 代失败

可热更新

风格控制权保留在 Prompt 协议 + Style Header,不绑死在 LoRA 权重

可跨系统

色板 / Visual Logic 字段从 AIGC 内容层自动延伸为 TD 粒子色彩与几何约束

协议层不是「风格指南 PDF」,而是把风格控制权、跨系统一致性、人机分工节奏写成 Token——下一个接手的人能复用,AI 模型能 attention,跨系统组件能映射。
5 层
子协议 Token
60 象
跨批次稳定
30

主视觉与现场落地 / Hero Visuals + Real Deployment

AIGC 内容层 × TD 实时交互层 × 穹顶物理落地 — 三层一致性的成品与现场

Hero Visuals · SD 生成集(过程版)+ 3 模式粒子对照

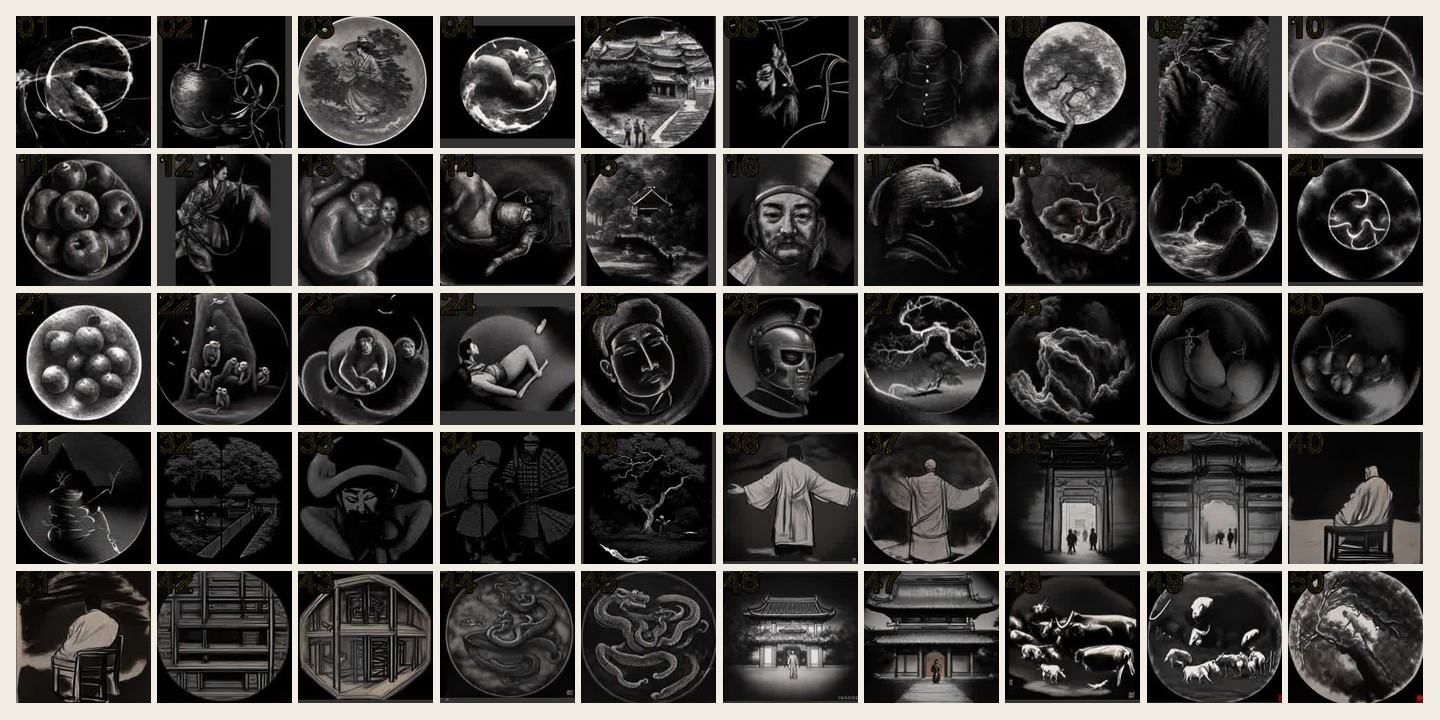
60 象 SD 白描生成集(过程版)— 缩略网格精选,体现跨批次生成的风格收敛与河图洛书数学化拆解(圆点数量 / 拓扑排布 / 阴阳计数)
SD 生成集(过程版)· 河图洛书数学化思维(圆点数量 / 拓扑排布 / 阴阳计数)+ 跨批次生成一致性
§T1 3-col + §T3.f · V1 · M1+M11 · B23+B71 · 共振 3 模式粒子对照 — 竖排 3 panel 同结构并置(M11):每 panel 左 = 该模式独立粒子运动 motif(吸引=向心收束 / 位置=轨迹流向 / 音频=FFT 频谱柱)右 = 模式名 + 驱动信号 chip + 隐喻;苔光 token motif base=--c-project / 核心 dot + 信号值=--c-accent PARTICLE · 粒子三模式对照 Attractor 能量吸引场 Position (x,y,d) 粒子向观众聚拢 · 被吸引 XY Interact 位置力场 Position + angle 手势驱动流向 · 主动影响 Audio-Reactive 音频映射 Audio bands · FFT 频段驱动振幅 · 声音共鸣

Real Deployment · 穹顶投影现场 + dome 装置实物

sphere_particles 球面粒子分布 · 穹顶实时呈现
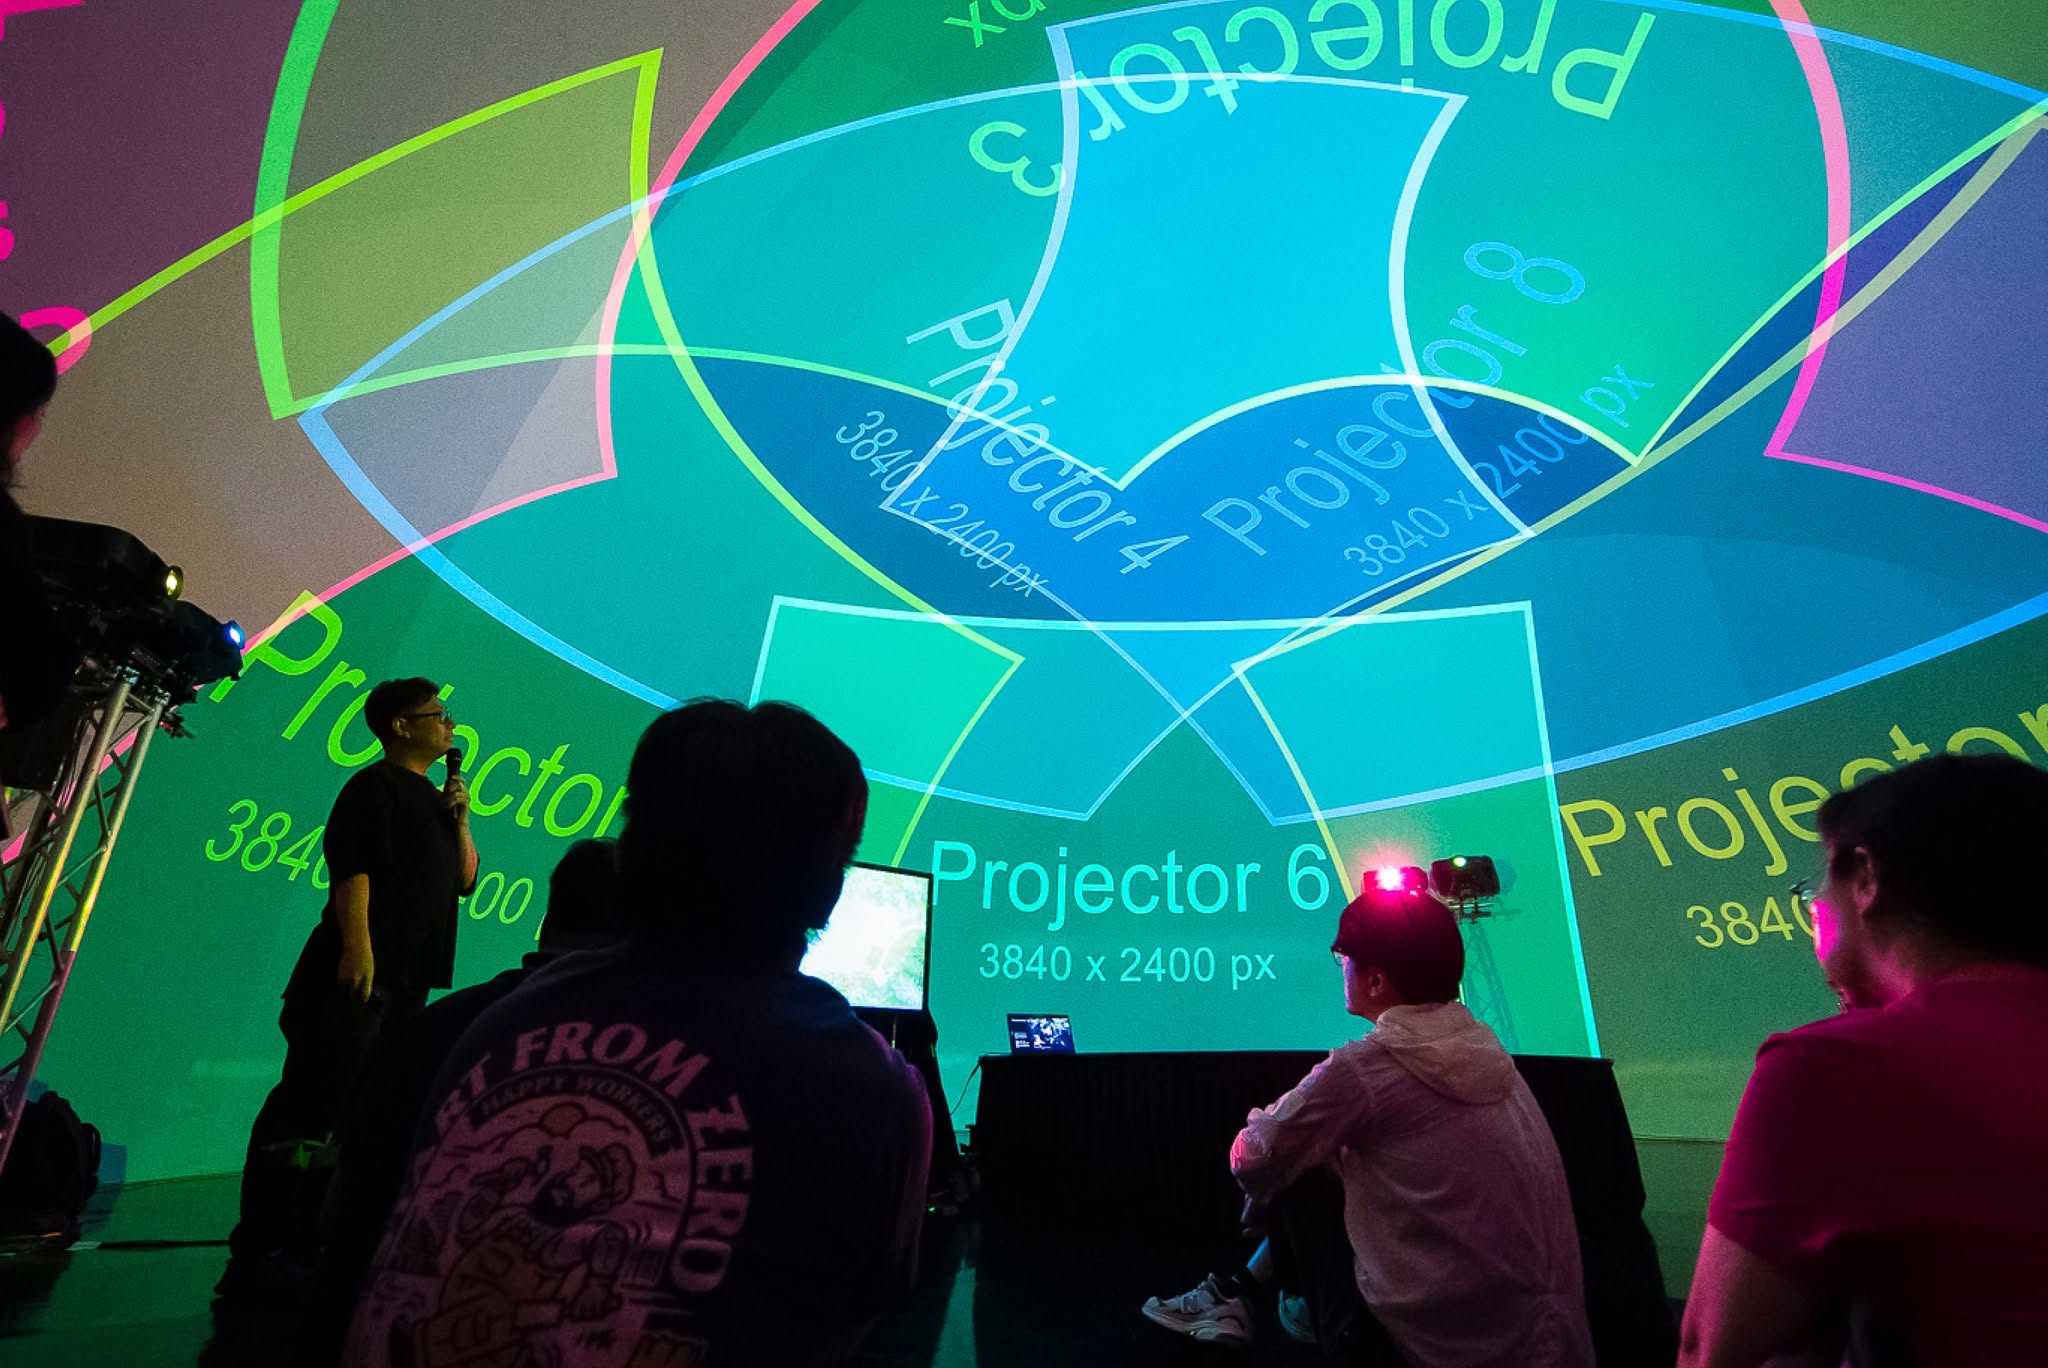
穹顶投影现场 — dome 几何装置全景 + 60 象内容在穹顶展示瞬间
穹顶投影现场 · dome 装置全景 + 内容展示瞬间(观众沉浸视角)
InsideDome — 穹顶内部沉浸视角 demo
InsideDome · 穹顶内部沉浸视角
sphere_particles — 球面粒子分布算法 demo
sphere_particles · 球面粒子分布算法
60 象
AIGC 跨批次稳定
3 模式
TD 实时粒子
3 代
SD Prompt 生产协议
31

复盘 · 五环叙事 / Reflection · Narrative

STAR 五环 — 让每个决策都附带它的归因

① 起点 / Situation

文化典籍《推背图》→ 可控·可批量 AIGC 图像集 → 穹顶实时装置内容源

② 约束 / Constraints

AIGC 输出不可控 × 穹顶实时呈现 × 跨系统漂移——三层张力 v1 起步同步压下

③ 关键决策 / Actions

  • 评估 LoRA 路径后主动放弃——团队评审 + 展览方多元化需求双重权衡,把已成熟的 LoRA 路径换成可文档化的 Prompt 工程协议
  • v3 几何降维三大法则——把 v1 经验性流程升级为 Style Header / Object Description / Negative Constraints 三层 schema
  • 4 步 HITL 工作流——以 Visual Logic 字段 + 5 秒/张 阻断节奏把 AI 幻觉锁在 Step 2/3 之间
  • 自研 color_palette 桥接组件——AIGC 输出色板 → 0-1 浮点空间标准化 → TD Ramp TOP,把跨系统漂移收敛在组件层

④ 量化结果 / Results

360 分析单元 · 3 代 SD 协议 · dome .64 · color_palette v1.0→v1.4

⑤ 认知升级 / Reflection · Hero

把图像语义降维为可执行的几何参数。

v3 三大法则不是「让模型理解推背图」,是「把图像语义降维为模型可以逐字执行的几何参数」——这条认知反向锁定了 Visual Logic 字段格式,也是 Doyle 价值驱动框架下「不让模型解释,只让模型执行」的工程化落地。
60
象 · ×6 维 = 360 单元
4
步 HITL 工作流
4
轮 color_palette 迭代
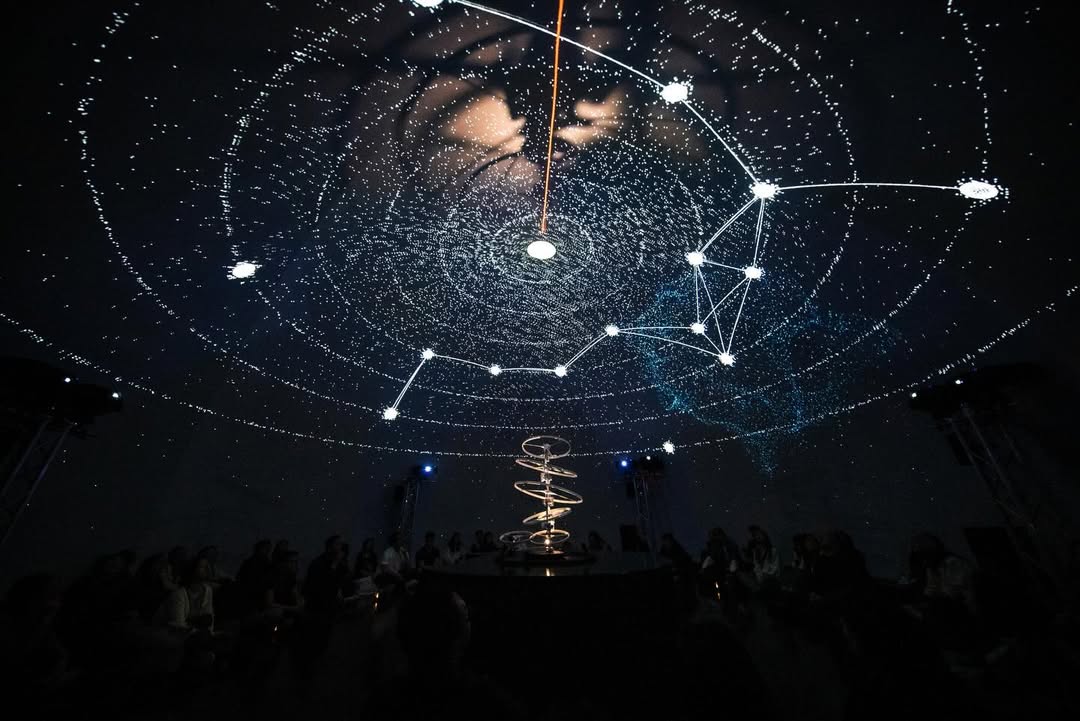
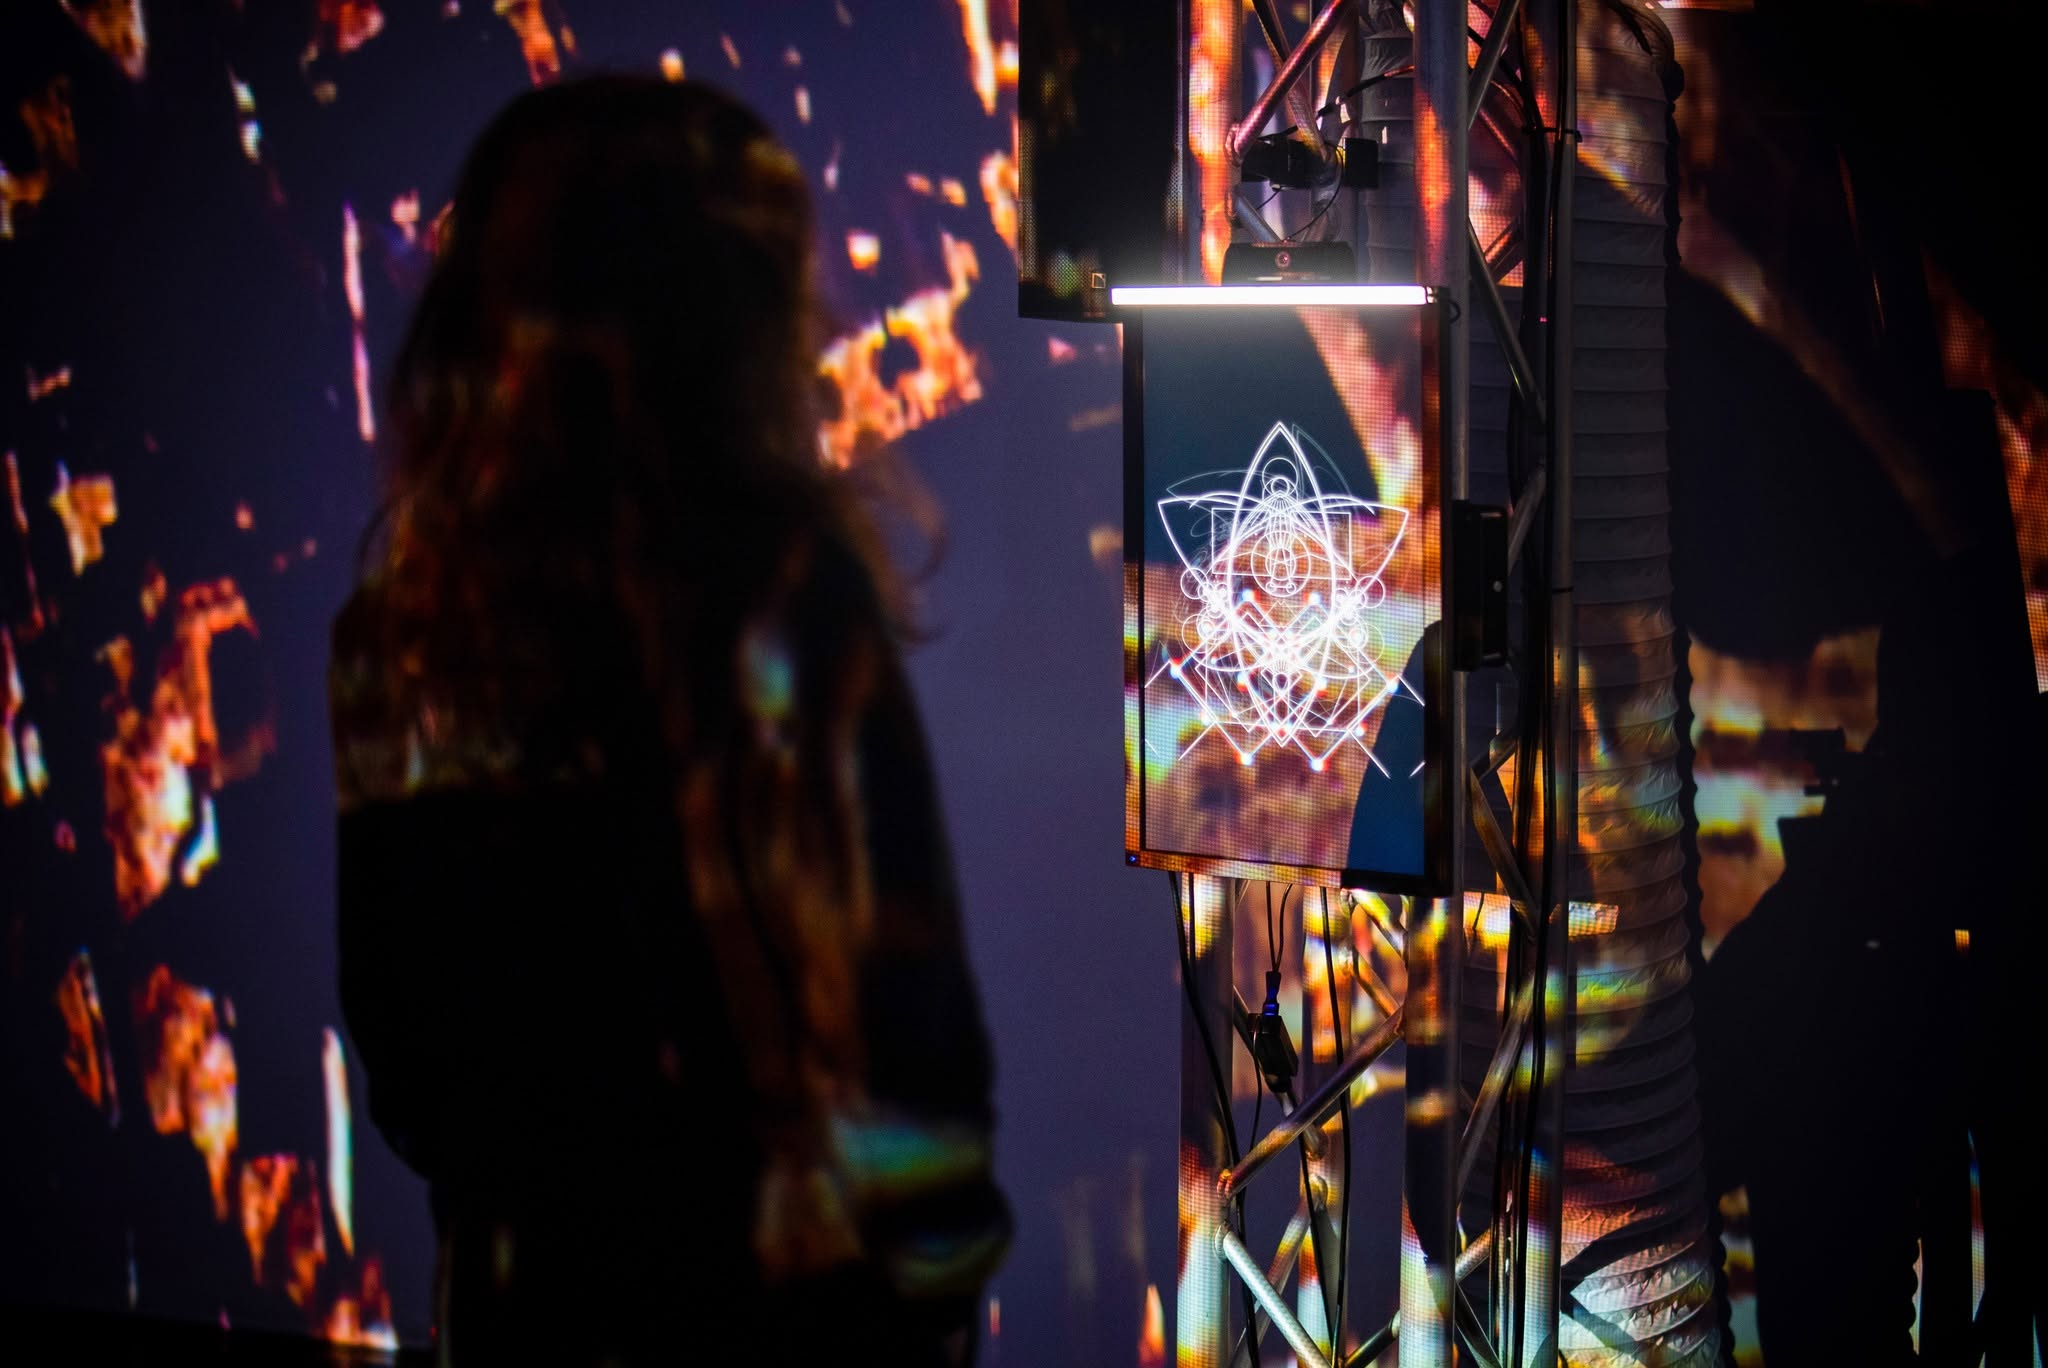
FutureScope 穹顶展现场 — 观众驻足于装置符号屏前
FutureScope 穹顶展现场 · 观众与实时符号画面
图像学逆向解码 SD Prompt 工程化 难点突破驱动 AIGC×TD 双层架构
32

复盘 · 验证矩阵 + 方法论 / Reflection · Matrix & Methodology

AI 装置没有 DAU,但有 5 维验证矩阵 — 让每个「怎么算成立」都明示给团队

5 维验证矩阵

维度 / Dimension 方法 / Method 节奏 / Cadence 验收标准 / Acceptance
SD Prompt 协议
修复 + 优化
v1 → v2 → v3 三代失败归因 + 4 步 HITL 工作流 每代 2-4 周 60 象可重复生成 + 战争片化 / 黑底反相 / 语义联想三类失败模式定性消除
3 模式粒子架构
探索
Art Team 盲测 + 主版本 v3 → v15+ 文件对照 每个主版本 3-4 周 Art Team 能识别「哪份是吸引场 / 位置力场 / 音频映射」+ 三模式视觉语言区分度足够
穹顶尺度呈现
修复
穹顶几何适配实测 + 投影机现场验证 dome modeling .v3 → .64 持续 6 个月 投影机现场呈现稳定 + dome_preview.mov 与实物输出对应
AIGC → TD 颜色桥接
探索
color_palette_generator.tox v1.0 → v1.4 实测 + Ramp TOP 视觉对照 每轮迭代 1-2 周 唐卡色板(从源画面取样的多层渐变 — 暖色系(氧化红→橙→金黄)为主体 + 末端青蓝冷调,冷色对比)的 AIGC 实际输出色 ≈ TD 粒子视觉色 + 4 轮迭代后误差可忽略
质性视觉反馈
质性
Art Team 盲测访谈 + 团队评审会节点反馈 v2 + v3 阶段 反复出现「白描风格统一 / 文化语境一致」高频反馈;展览方多元化需求反向验证 LoRA 弃用决策正确

核心收获

方法论迁移 ①

Prompt 工程不是写作技巧

3 代协议 + 4 步 HITL 让我真正理解 AIGC 工程化的内核——Prompt 工程是「失败归因 + 可审核中间字段 + 针对性负面预判 + 团队可对接文档」的协议设计。

方法论迁移 ②

跨系统一致性只能靠工程组件

color_palette_generator.tox 的 4 轮迭代让我相信——靠规范文档约束跨系统视觉一致性在长尺度下会出现漂移,组件化 + 自动化管道 + 0-1 浮点标准化是更可持续的解法。设计系统最佳实践从此扩展到 AI 内容层 ↔ 实时交互层。

2 条核心原则

#1 先定义成功,再上线

— v1 阶段没有先定义「白描风格的可识别阈值」,失败时只能凭直觉判断「不像」,无法系统归因;v3 阶段先锁定 Style Header + Object Description 三大法则作为成功标准,决策效率提升一个数量级。

#2 没有结论也是结论

— 「为什么 v1 学术语义失败」与「为什么 v3 几何降维成立」同等重要——前者直接驱动了三大法则的诞生(几何降维 / 去语义化 / 强制隔离),后者只是把法则落地。所有「最终方案」都包裹着多个「被否方案」的归因记录。

下次会做得不一样的 3 件事

①

更早把失败案例归因做成结构化模板(触发场景 / 现象 / 归因假设 / 验证方法 / 修正方向),让 v2→v3 有更早的结构化推理依据,省 2-3 周经验性试错

②

更早建立颜色桥接组件的标准化测试集——准备一套覆盖不同色彩结构的已知触发问题参考图集合,迭代效率显著提升

③

更早接入第三方视觉评审作为 HITL 盲测节点——当前主要由我个人执行 Visual Logic 审核,引入 Art Team / 策展人独立盲测可让「文化语境一致性」判断有第三方可信度

33
眾生鏡主视觉 — UABB 装置现场 + AI 生成香港建筑材质变换效果

PROJECT 02 — AI PRODUCT SYSTEM BUILDER · 数据分析驱动

眾生鏡 Sentient Mirror

我把 v1 阶段观众输入权重 1.0× 主动压到 0.25× — 让 AI 装置叙事从 StreamDiffusion SDK 初始配置的「观众主导生成」翻转为「策展主导 + 用户调味」的可控工程平衡

0.25×
观众输入权重 — v1 初始基线 1.0× 主动压低;A/B 实测验证
5×7 = 35
把香港建筑集体记忆预编成 5 建筑 × 7 材质可组合设计 Token
— 观众情绪经 7×7 调研直连材质映射

核心挑战  UABB 双年展语境下,项目 v1 直接采用 StreamDiffusion SDK 初始配置上线(单层 Prompt + 观众输入 1.0× + 自由 CFG),AI 频繁滑向霓虹 / 赛博 / 中世纪等模型先验偏差 — v1 实测撞到这条边界后,我把工程目标重定为「策展主导 + 用户调味」

服务对象  UABB 现场观众(对场所精神有具身记忆)· 策展团队(需「集体记忆性」与「个人参与感」的可控平衡)

项目立足点  把场所认知心理学(Genius Loci / Lynch / Bachelard / Metabolism)转化为可量化 AI 行为参数,团队内没有现成可参照的工程协议;本项目把理论从哲学层级一路下放到 Prompt 权重层级

最终成果  三层独立可调权重 Prompt 架构(Structure / Material / Context)+ 5 建筑 × 7 材质 = 35 组 Prompt 矩阵 + 7×7 情绪×材质调研建立情绪→材质映射 + 6 情绪映射 × MediaPipe ≥25fps 实时驱动材质切换 + 100+ 版本化生成视频作为 A/B 决策证据

项目独立设计 Token-as-Prompt 协议 0.25× 输入权重主动锁定 5×7=35 Prompt 矩阵 · 情绪→材质映射 AI 行为参数工程化
14
Timeline 2025.10 — 2025.12(XCEPT 实习 / UABB 备展周期)
My Role UX Designer & AI System Builder
Team XCEPT × UABB Bi-City Biennale 备展线
Type 实时 AI 互动装置(StreamDiffusion + TD + MediaPipe)

项目概览 / Project Overview

为 UABB 双年展打造的 AI 装置 — 集体记忆 × 个人参与的可控平衡

张力 1

集体性 vs 个体性

策展团队要的是「集体记忆体验」(观众体验他者的香港),但 AIGC 工具的默认假设是「最大化个人表达」(输入权重越高越自由)——两者方向相反。

如何用 AI 行为参数表达策展意图?

集体记忆体验 ↔ 最大化个人表达 · 方向相反

张力 2

AI 行为不可控的工程瓶颈

v1 使用观众输入权重 ≥ 1.0× 时,生成结果频繁滑向模型先验偏差,完全失去香港地方性。

这不是 Prompt 写得不够好,是模型概率分布层的问题。

霓虹 / 赛博朋克 / 中世纪城堡 / 中式飞檐 → 模型先验偏差

张力 3

审美 vs 数据可验证性

策展团队需要「视觉风格在不同观众输入下保持可识别的香港感」——把「视觉一致性」这件主观事变成有调研数据支撑的客观决策。

装置艺术评估难定量。

「视觉一致性」主观事 → 调研数据支撑的客观决策
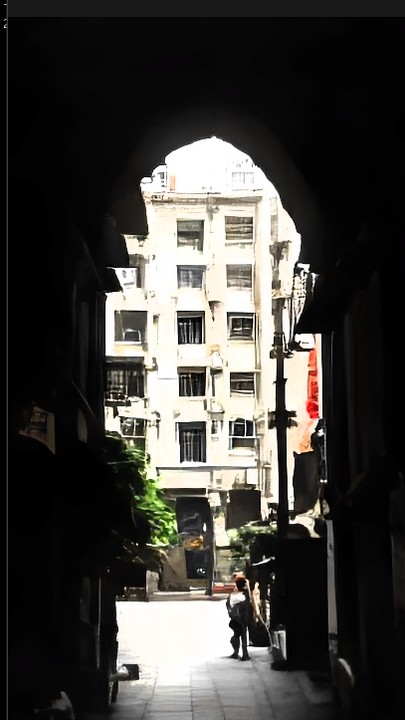
1.0× v1 初始基线 · 失败
场景化 / 剪影构图 / 伪影 — 材质被淹没
1.0× 失败 — 剪影暗巷构图 1.0× 失败 — 场景杂乱伪影 1.0× 失败 — 畸变 skyscraper
↓  主动压低观众输入权重
0.25× 终版 · 成功
建筑本体清晰 · 材质/结构特质突出
0.25× 终版 — 混凝土塔 0.25× 终版 — 唐楼材质 0.25× 终版 — 殖民柱
观众要的不是「我在 AI 镜头里看到自己」,而是「在他者集体记忆的合成空间里照见香港」——这要求 AI 输入参数从「用户主导」转向「策展主导 + 用户调味」。
15

探索研究 / Research Study

场所精神 → 三类问题池(20 题)+ 7×7 = 49 组情绪 × 材质混合调研

研究对象是观众认知与 AI 行为参数的耦合关系——项目 v1 按 StreamDiffusion SDK 初始配置上线(单层 Prompt + 观众输入权重 1.0× + 自由 CFG),v1 实测撞到 SDK 工程取向(观众输入主导生成结果)与策展立项命题(「集体记忆体验」由策展主导)方向相反的边界。我要先解决的不是「Prompt 怎么写更好」,而是「哪些参数应该让用户控制、哪些不应该」。

用研要回答的核心问题三问 / Core research questions

  1. 观众究竟靠什么线索识别「这是香港」?
  2. 哪些视觉元素是可以个体化的、哪些必须策展锁定?
  3. 情绪输入和视觉材质之间是否存在用户认可的稳定对应关系?

三条并行研究主线:

①Theory Anchors

场所精神框架的设计转化

研究底层锚定 Kevin Lynch 城市意象五要素(Path / Edge / District / Node / Landmark)与 Relph 场所三维度(物理 / 活动 / 意义),将抽象的场所精神理论直接推导为三类问题池的结构设计——每一条理论锚点都对应一个具体的用户输入分类参数。

②Question Pools

三类问题池设计(20 题)

Memory(地点记忆 · 场所驱动)/ Emotion(情绪感受 · 与 Ekman 6 情绪呼应)/ Local Clues(在地线索 · 地标+感官驱动)——让用户输入有结构而非自由文本。

③Survey Matrix

多源调研矩阵

6 维度感知问卷 + 11 题情感词汇采集 + 7×7 = 49 组情绪×材质 Google Form 调研(7 类材质 × 7 类情绪)——从中筛选高对应度组合,让审美决策变成数据决策。

CONCEPT MAP A · 场所精神 → 三类问题池 THEORY ANCHORS CONVERGE QUESTION POOLS · 驱动方向各不同 定向 / 认同 ORIENTATION / IDENTIFICATION 双轴分类脊 ① 场所精神 · 地方为何「是这里」 分类体系的根 ★ / Genius Loci · 诺伯格-舒尔茨 — 产生定向·认同双轴 ② 城市意象 · 人靠什么认路记城 挂定向轴 · 供 Orientation / Image of the City · 凯文·林奇 — 五类认路线索 语境锚(弱权重 · 不直接推导) ③ 雷尔夫 · 场所与无场所 / PLACE & PLACELESSNESS — 同质化批判语境 ④ 巴什拉 · 空间诗学 / POETICS OF SPACE — 个人情感的小尺度入口 ⑤ 新陈代谢派 / METABOLISM — 记忆物质化 地点记忆 MEMORY POOL · 场所驱动 情节 地点 情绪感受 EMOTION POOL · 情绪驱动 ↔ Ekman 6 感受 场所 在地线索 LOCAL CLUES · 地标 + 感官驱动 识别 联想

4 个核心洞察

洞察 1「集体记忆」与「最大输入自由」是冲突需求

v1 测试中观众输入权重 1.0× 下生成结果频繁滑向模型先验偏差

洞察 2观众的「香港识别力」依赖少数视觉锚点

6 维度问卷高频词集中在少数材质类型

洞察 3情绪→材质对应不是均匀分布

7×7=49 组调研中不同材质对情绪的关联强度差异显著,据此为每类情绪建立高对应材质映射

洞察 4用户对「他者记忆体验」的接受度高于「个人镜像」

装置叙事方向锁定为「观众体验他者的香港」

49 组
情绪×材质调研
20 题
三类问题池
5 部
核心理论文献
16

设计策略 / Design Strategy

三条策略主线 — 系统化 Prompt × 策展主导 × 数据驱动审美

研究告诉我「装置叙事是策展主导 + 用户调味」——但这个洞察可以走非常不同的方案路径。策略层的工作是在这些路径里选一条主道,并明确放弃哪些。

①System over Heuristics

Prompt 系统化

通过三层独立可调权重的 Prompt 架构(System / Context / Task)+ 对抗性负面空间,改变 AI 模型先验偏差对生成结果的统计学统治,达成让香港建筑视觉语言在跨场景下稳定可识别。

放弃 ✕ 单体大提示词 ✕ 纯加法引导 ✕ 经验性拍脑袋调参

②Curatorial Lead

策展主导

通过将观众输入权重压低至 0.25×、策展模板权重锁定 0.75×、CFG 限制在 6-7,改变 v1 实测中「最大输入自由 → 模型先验全面接管」的实际表现,达成让 AI 输出在策展叙事一致性下保留观众参与感。

放弃 ✕ 自由 CFG ✕ 自由观众输入权重(v1 初始基线 1.0× 已被 v1 测试证伪) ✕ LoRA 风格迁移路径

③Data-Driven Aesthetics

研究驱动审美决策

通过 7×7 情绪×材质调研 + 6 维度感知问卷 + 11 题情感词汇采集,改变装置艺术「视觉决策靠美学直觉」的传统做法,达成让情绪→材质的映射选择有可追溯的实证依据。

放弃 ✕ 「我觉得这种材质好看」的主观决策 ✕ 单一专家盲选 ✕ 艺术家个人偏好强加
眾生 · 策略推导映射图 三层推导:上层 p16 四项研究洞察加第五节点 v1 现场观察(虚线区分来源),经映射线收敛到中层三条策略主线(Prompt 系统化 源自① / 策展主导 源自①④⑤ / 研究驱动审美 源自②③),再各自分叉为下层双支取舍(实线直行 = 保留项 · 虚线岔出 = 放弃项)。§T 映射 · V3 · 源: p16 洞察 1-4 + v1 现场观察 → 本页 3 策略。 STRATEGY DERIVATION · 策略推导 4 洞察 + 观察 → 3 策略 → 取舍 ① 核心洞察 / INSIGHTS ① 先验偏差统治 权重 1.0× 证伪 ② 锚点集中 6 维问卷高频词 ③ 关联不均 7×7=49 调研 ④ 他者记忆 高于个人镜像 ⑤ 行为双型 v1 现场观察 / FIELD ② 策略主线 / STRATEGIES 源自 ① 源自 ①④⑤ 源自 ②③ Prompt 系统化 策展主导 研究驱动审美 System over Heuristics Curatorial Lead Data-Driven Aesthetics ③ 方案取舍 / TRADE-OFFS 保留 / KEEP ✓ 三层可调权重架构 ✓ 对抗性负面空间 放弃 / DROP ✕ 单体大提示词 ✕ 纯加法引导 ✕ 拍脑袋调参 保留 / KEEP ✓ 观众输入 0.25× 限权 ✓ 策展模板 0.75× 锁定 放弃 / DROP ✕ 自由 CFG ✕ 输入权重 1.0×(证伪) ✕ LoRA 迁移路径 保留 / KEEP ✓ 7×7 情绪→材质映射 放弃 / DROP ✕ 主观审美决策 ✕ 专家盲选 ✕ 偏好强加

单体提示词、自由观众权重、审美直觉——三条「看似自由」的路径都被主动放弃。三条策略共享一个内核:把装置的视觉一致性从个人直觉,收束到可调权重、策展锁定与实证数据上。

17
方案展示 I · 数据分析驱动 / Solution I · Data-Driven

项目独立设计 Token-as-Prompt 协议 — 三层权重架构 + 主动淘汰 LoRA

眾生 · 三层 Prompt 权重架构(比例编码·子弹图变体):L1 Concept 0.30 / L2 Surface 0.40-0.45 材质层权重最高 / L3 Context 0.15-0.30 + 观众输入限权 0.25× 三层 Prompt 内部加权(条长 = 权重量级·子弹图变体):L1 Concept/Subject 空间几何 权重 0.30 / L2 Surface/Skin 材质色彩 7×7 高频词云 权重 0.40-0.45(最高·视觉主导)/ L3 How It's Seen 视角光线 权重 0.15-0.30;观众实时输入限权 0.25×(v1 1.0× 逐轮降至终版 0.25×·A/B 验证·条尾落 0.25 轴线)。主动淘汰 LoRA → SD Prompt 工程化加权。Token 分层抽象见视觉系统页·生成结果见 p19 Solution II 真图。spec: #8 眾生三层权重 · 权重比例编码(替代 §T1.d 等角避与 p10 共振#1 同型 + 更有效传达量化权重)· M10 比例 + r8 焦点编码 · 数据分析驱动 PROMPT WEIGHT SCHEMA 策展模板 · 条长 = 权重量级 0 0.25 0.50 L1 Concept / Subject 空间类型 + 几何结构 + 固定物理特征 0.30 L2 Surface / Skin 材质 + 肌理 + 色彩 · 7×7 调研高频词云 0.40-0.45 L3 How It's Seen 视角 + 光线 + 曝光 0.15-0.30 观众 v1 1.0× → 0.4× → 0.25× 终版(A/B 验证) 0.25×
这三层架构等效于设计系统中的 Brand Token → Component Token → Context Token 分层——我把传统设计系统的 Token 分层逻辑迁移到了 AI Prompt 工程中。这不是「写 Prompt」,是把 AI 行为参数当成设计系统的 Token 来管理。

FigJam Source of Truth · 7 材质词典

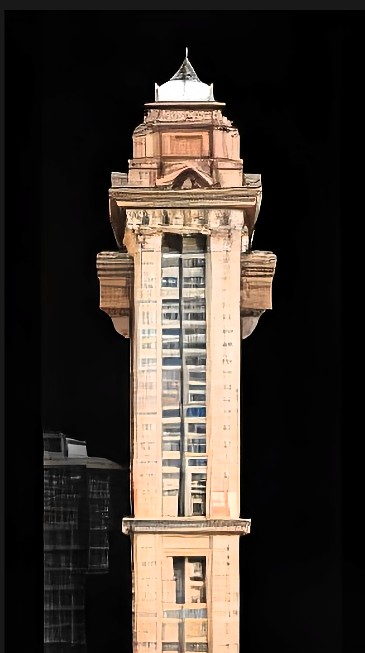
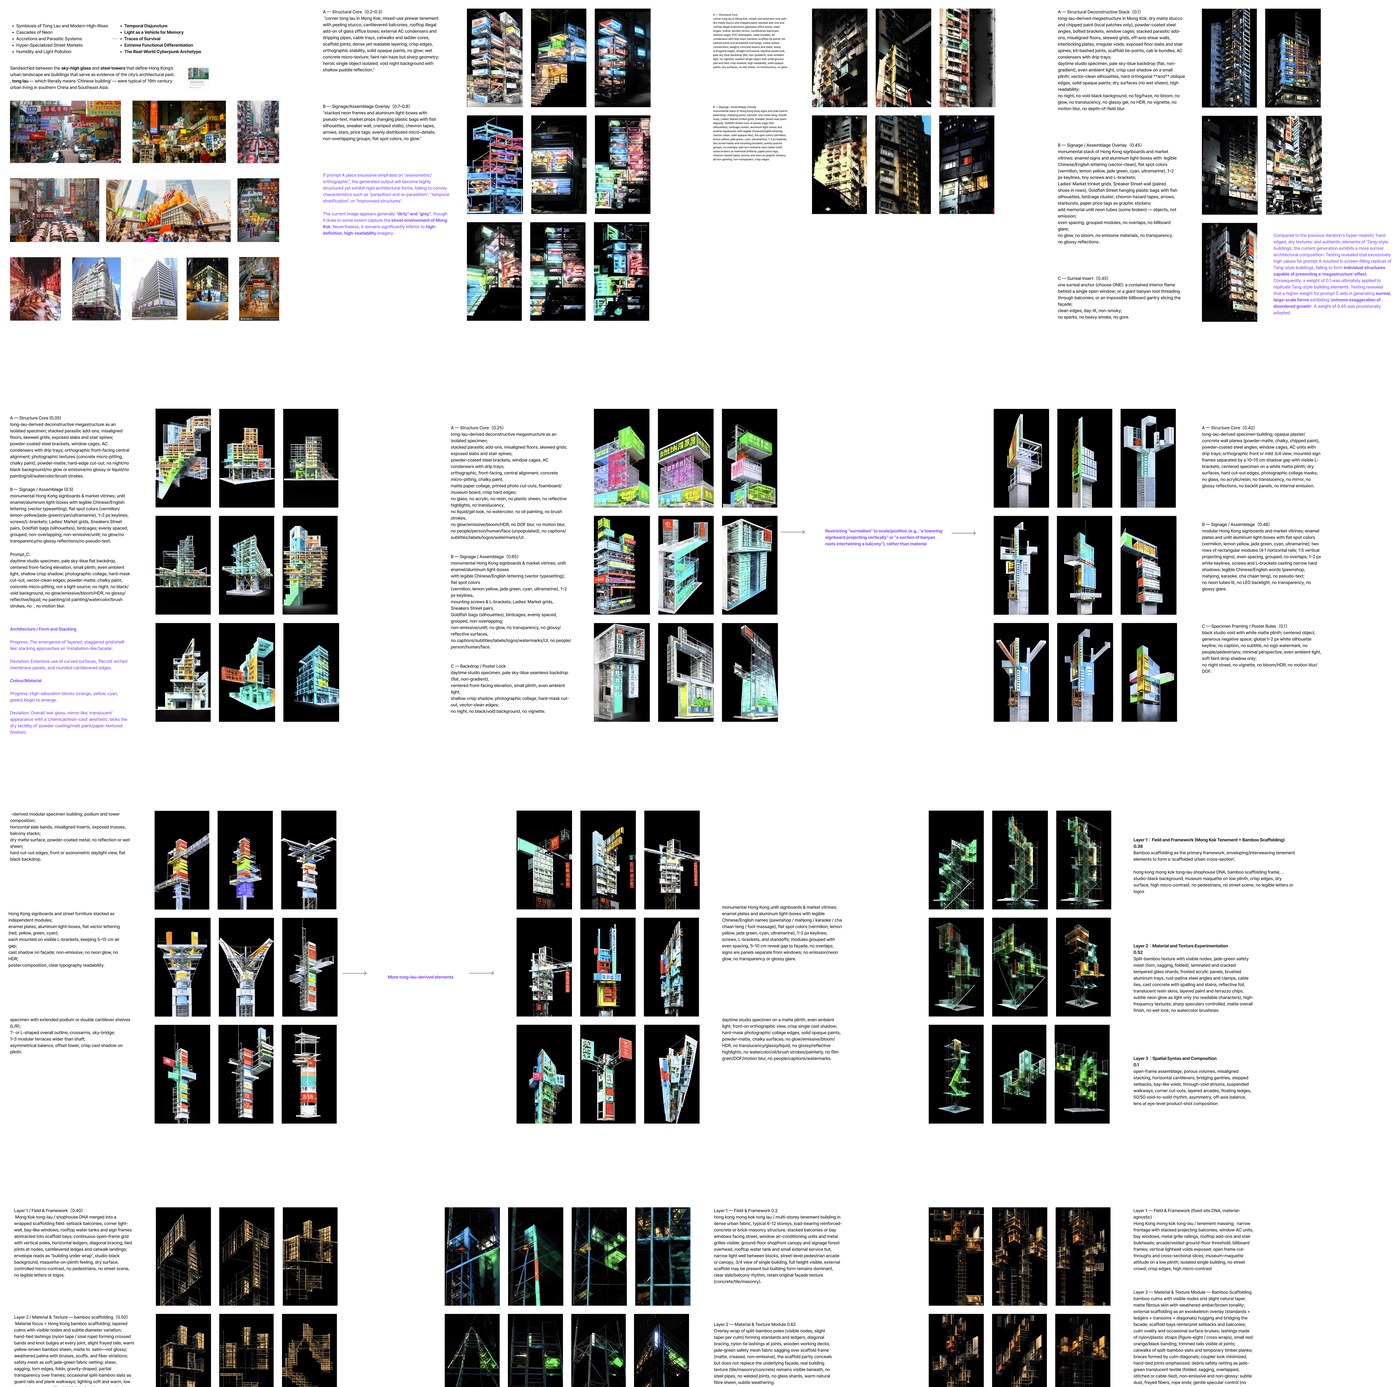
FigJam 设计看板顶部 — Prompt 分层 spec(A Structure Core / B Signage Overlay · L1/L2/L3)+ 7 材质词典 + 塔形材质迭代

关键决策溯源

路径选择 主动淘汰 LoRA → SD Prompt 工程化(训练成本高 / 版本 diff 困难 / 与策展叙事强耦合)

权重比例 观众输入从 1.0×(v1 初始基线)→ 0.4×(v1 草稿)→ 0.25×(终版),v1→v3 A/B 测试验证

CFG 控制 压低至 6-7(< 6 风格不稳定 / > 7 表面塑料感),100+ 版本化记录验证

5 建筑 × 7 材质 = 35 组 Prompt 矩阵——7 材质(霓虹/竹棚/马赛克/混凝土/玻璃/通花鐵閘/殖民红砖)× 5 建筑(中银/殖民/唐楼/公屋内·外)

Prompt 句法 自然语言段落(v4.x 早期)→ 纯关键词列表(v4.20),减少注意力稀释

负面 Prompt 显式负面空间构建,直接屏蔽「夜景/飞檐/中世纪」高概率先验

18
方案展示 II · 数据分析驱动 / Solution II · Data-Driven

v1→v3 三轮 A/B + v4.x 子版本细分 — 每轮推翻一个旧判断

①架构层 v1→v3 × 子版本层 v4.x

v1

早期自由式 触发重构

单层自由 Prompt + 观众输入 ≥ 1.0× + 自由 CFG。生成风格无法预期,Art Team 反馈「不像香港」;模型先验偏差频繁出现 → 触发「分层 + 权重压低」需求。

v2

三层架构草稿 部分验证

form / material / ambience 三层分离 + 观众输入 ≤ 0.4× + 负面 Prompt。三层独立调参可行 但 0.4× 仍导致部分场景偏移 → 触发「进一步降权 + 精确断代词汇」。

v3

终版 + 7×7 调研锁定 稳定

Structure / Material / Context 三层 + 模板 0.75× / 观众 0.25× / CFG 6-7 + 5 建筑×7 材质矩阵。7×7 调研数据 + A/B 测试共同支撑权重决策。

v4.x

StreamDiffusion 子版本

(以「通花铁闸」v4.1→v4.20 为例)v4.6「单一叙事流」失败(概念过载)→ v4.15 语境翻译(quatrefoil/猪腰花)→ v4.19「立面即框架」失败 → v4.20「分块加权 + 上下文冗余 + 纯关键字列表」稳定。
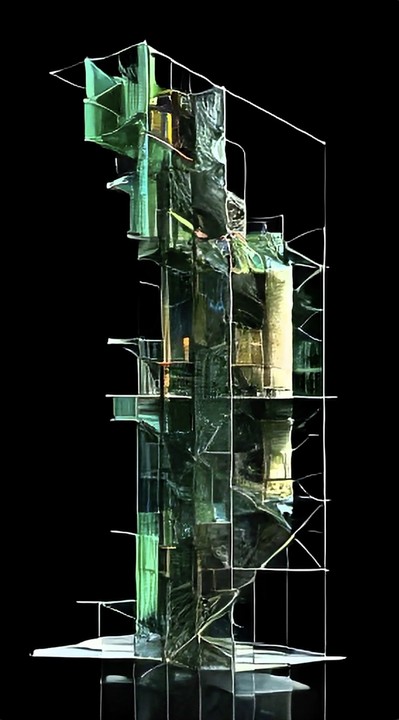
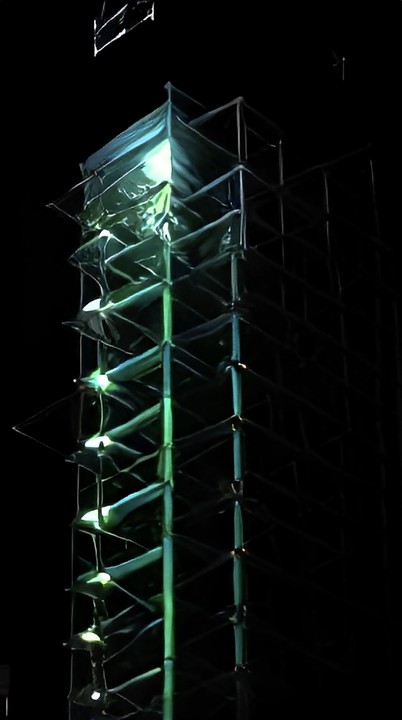
v1 早期自由式
v1 早期自由式
单层自由 Prompt
v2 三层架构草稿
v2 三层架构草稿
form/material/ambience
v3 终版 + 7×7 锁定
v3 终版 + 7×7 锁定
Structure/Material/Context
v1→v3 三代生成对比 · 早期自由式 → 三层架构 → 终版锁定(v4.x 通花铁闸子版本见左)

②观众的表情,实时驱动材质切换

MediaPipe 表情识别捕捉 Ekman 6 基础情绪(anger / disgust / fear / happiness / sadness / surprise),实时映射到 L2 Material Layer 的 7 材质切换;可用性门槛 ≥25fps 实时分类,确保观众感知到「装置在看着我」的因果。

这套系统构成了一个双通道人机协作范式:策展引导通道(三层 Prompt 权重架构锁定叙事一致性)+ 实时情绪微调通道(Ekman × MediaPipe 让观众的身体反应直接影响视觉输出)——两条通道的并行让装置既不是「纯策展独裁」也不是「纯用户自由」,而是一种可量化的中间态。

③端到端 UX 交付

7 类双语材质词典 · ≥15 份 Prompt 规范 · ≥60 张实地参考照片 · ≥72 张 AI 迭代图 · 100+ 版本化生成视频 · FigJam 设计看板(团队 Source of Truth)

100+
版本化生成视频
≥25fps
情绪实时分类
0.25×
观众输入权重
19

视觉系统 / Visual System

视觉系统不是材质列表,是 Token + 词典 + 字段 + 双通道 + 推导链的 5 层协议

P.5 讲三层 Prompt 权重的具体决策(L1 0.30 / L2 0.40–0.45 / L3 0.15–0.30 逐套动态映射 + 0.25× 观众输入),这一页讲这套权重如何成为视觉系统的协议层——把 Solution I 的方案级 AI 行为参数,抽象为跨项目可复用的 5 个子协议:Token Schema / Materials Canon / Glossary / Affect Channel / Place Spirit Funnel。

5 子协议 · 把方案级决策上升到协议级 Token

①Token Schema

三层 Prompt 权重 = 设计系统 Token 分层

L1 Concept / L2 Surface / L3 Context 三层权重不是「调参经验」,而是把 Brand / Component / Context Token 分层逻辑迁移到 AI Prompt 工程——AI 行为参数被当作设计系统的 Token 来管理,权重比例可文档化、可 A/B 验证、可跨场景复用。

②Materials Canon

7 材质 Skin Token · 5×7=35 矩阵

7 类香港本地材质——霓虹 / 竹棚 / 马赛克 / 混凝土 / 玻璃 / 通花鐵閘 / 殖民红砖,与 5 类建筑(中银 / 殖民 / 唐楼 / 公屋内·外)组合成 35 组 Prompt 矩阵(arch_prompts A01-A05 × mat_prompts M01-M07)。Skin Token 集合资产化——不是「材质配方」,是可热替换、可扩展、可团队共建的材质 Token 集。

③Glossary

7 类双语材质词典

7 大类双语映射——把田野调研的香港本地视觉符号编码为 AI 模型可 attention 的关键词集合。词典层是 Schema 之下、Prompt 之上的协议中介,把文化研究的「软语义」与 SD 的「硬关键词」桥接起来。

④Affect Channel

观众的情绪,也是系统里的一个 Token

Ekman 6 基础情绪 LUT × MediaPipe ≥25fps 实时表情识别——表情数据流驱动 L2 Material Layer 切换。情绪也被 Token 化,与 Surface / Skin 层共享同一组协议;不是「为情绪写一段代码」,是「把情绪挂进 Token 系统」。

⑤Place Spirit Funnel

把「地方为何是这里」拆成三类能问的用户问题

Lynch 城市意象 5 要素(路径 / 边界 / 区域 / 节点 / 地标)→ 收敛到三类问题池:Memory / Emotion / Local Clues → 驱动用研问卷设计 → 输出到词典 + canon。视觉系统的「上游协议」——把抽象的「场所精神」做成可走通的研究漏斗。

系统已搭建 · TouchDesigner 管线
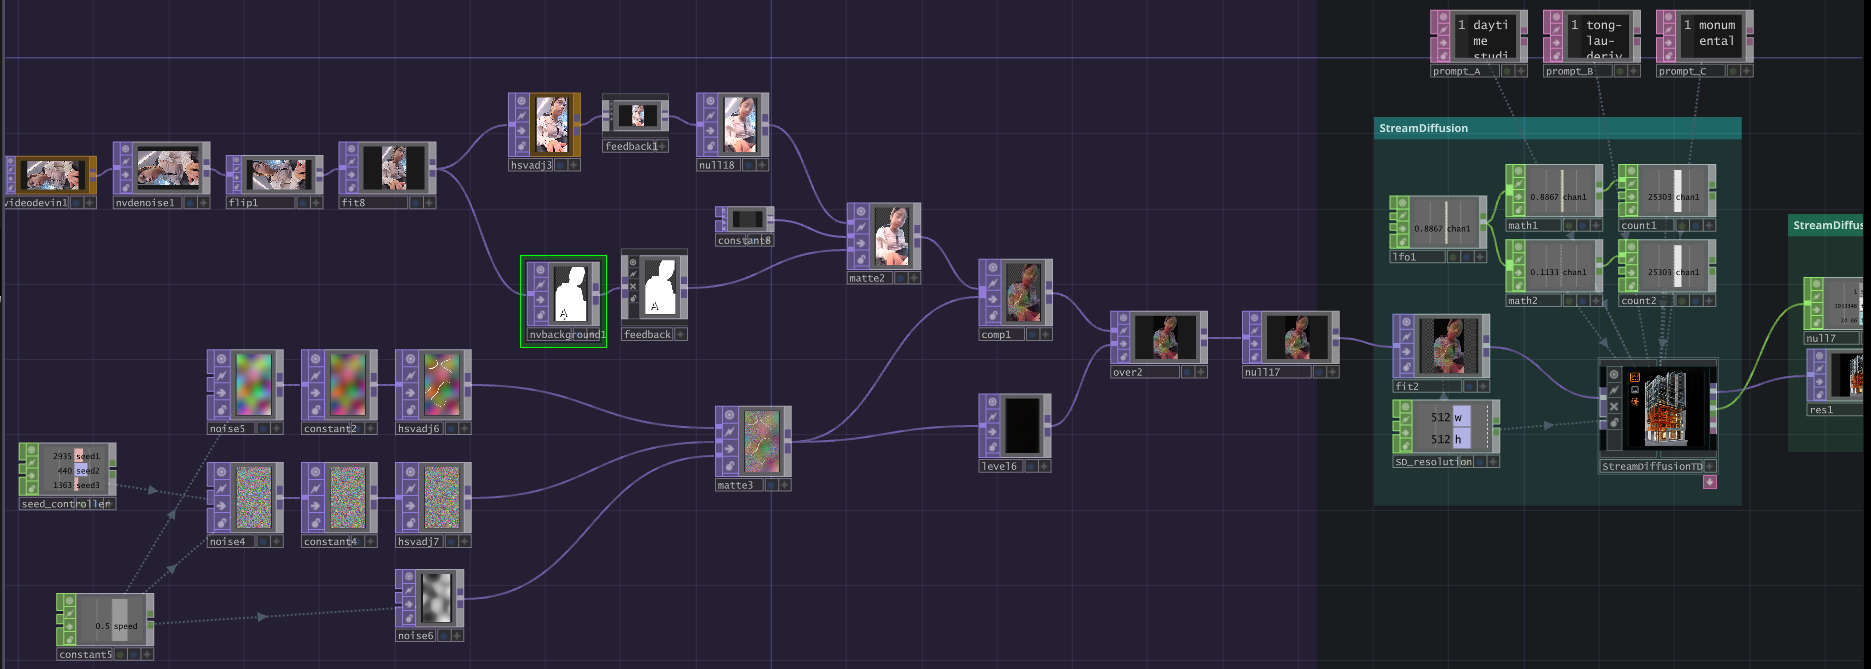
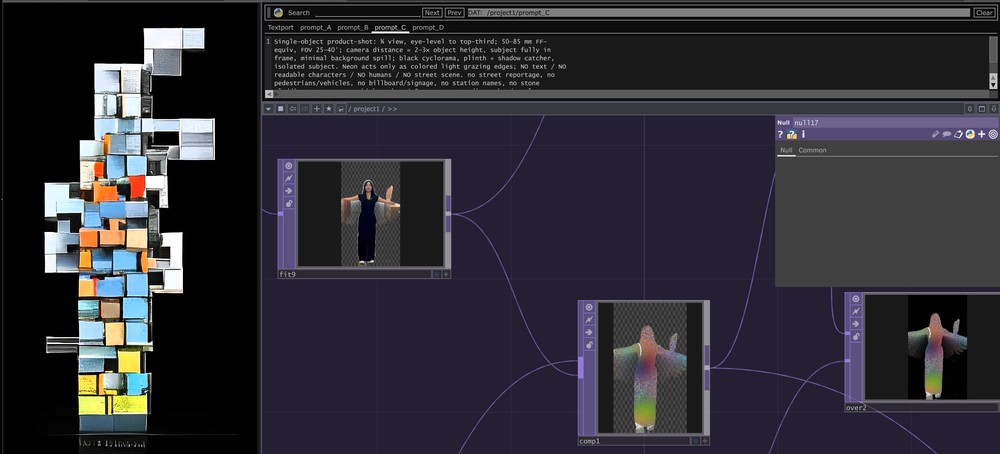
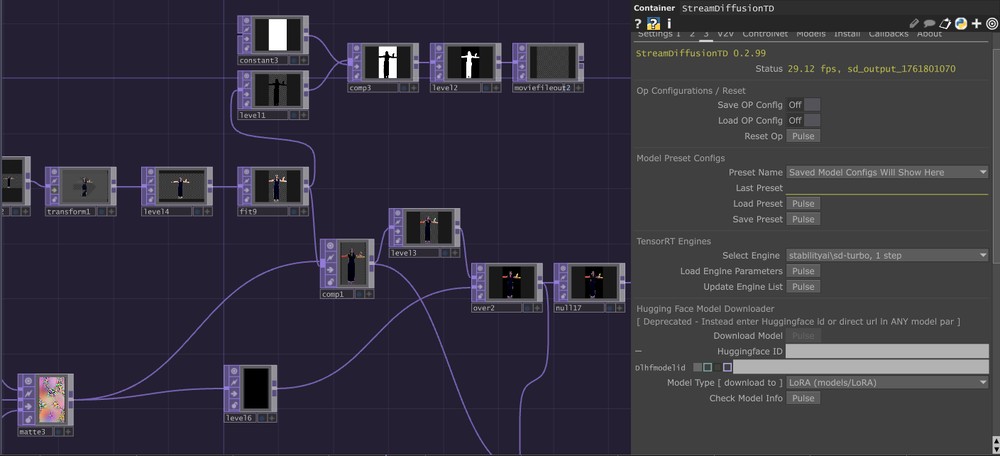
TouchDesigner 节点图 — 5 子协议落成可运行系统
TouchDesigner 节点图 — 5 子协议落成可运行系统(prompt 加权 + 材质切换 + StreamDiffusionTD 编排)

协议化的工程价值

可文档化

5 子协议 + 双语词典 + 7 材质 都进 FigJam 看板,团队 1.5 月内 onboarding

可热替换

材质库可扩展(v4.20 通花铁闸即来自城市观察的新增材质)

可跨学科

Lynch 城市意象 / Ekman 情绪 / SD attention 三套语言被同一组 Token 桥接

视觉系统不是「材质指南」,是把用研、文化、情绪、AI、设计系统用同一组 Token 串起来——下一个香港艺术装置不用重做用研,可以直接 fork 这套协议。
5 层
子协议 Token
7 类
双语材质词典
20

主视觉与现场落地 / Hero Visuals + Real Deployment

100+ 版本化输出 × 7 材质 × 6 情绪 × UABB 现场 — 三层一致性的成品与落地

Hero Visuals · 100+ 版本化输出 + 7 材质 specimen

素材源:100+ 视频 / 7 材质 specimen(Phase 4 选品)
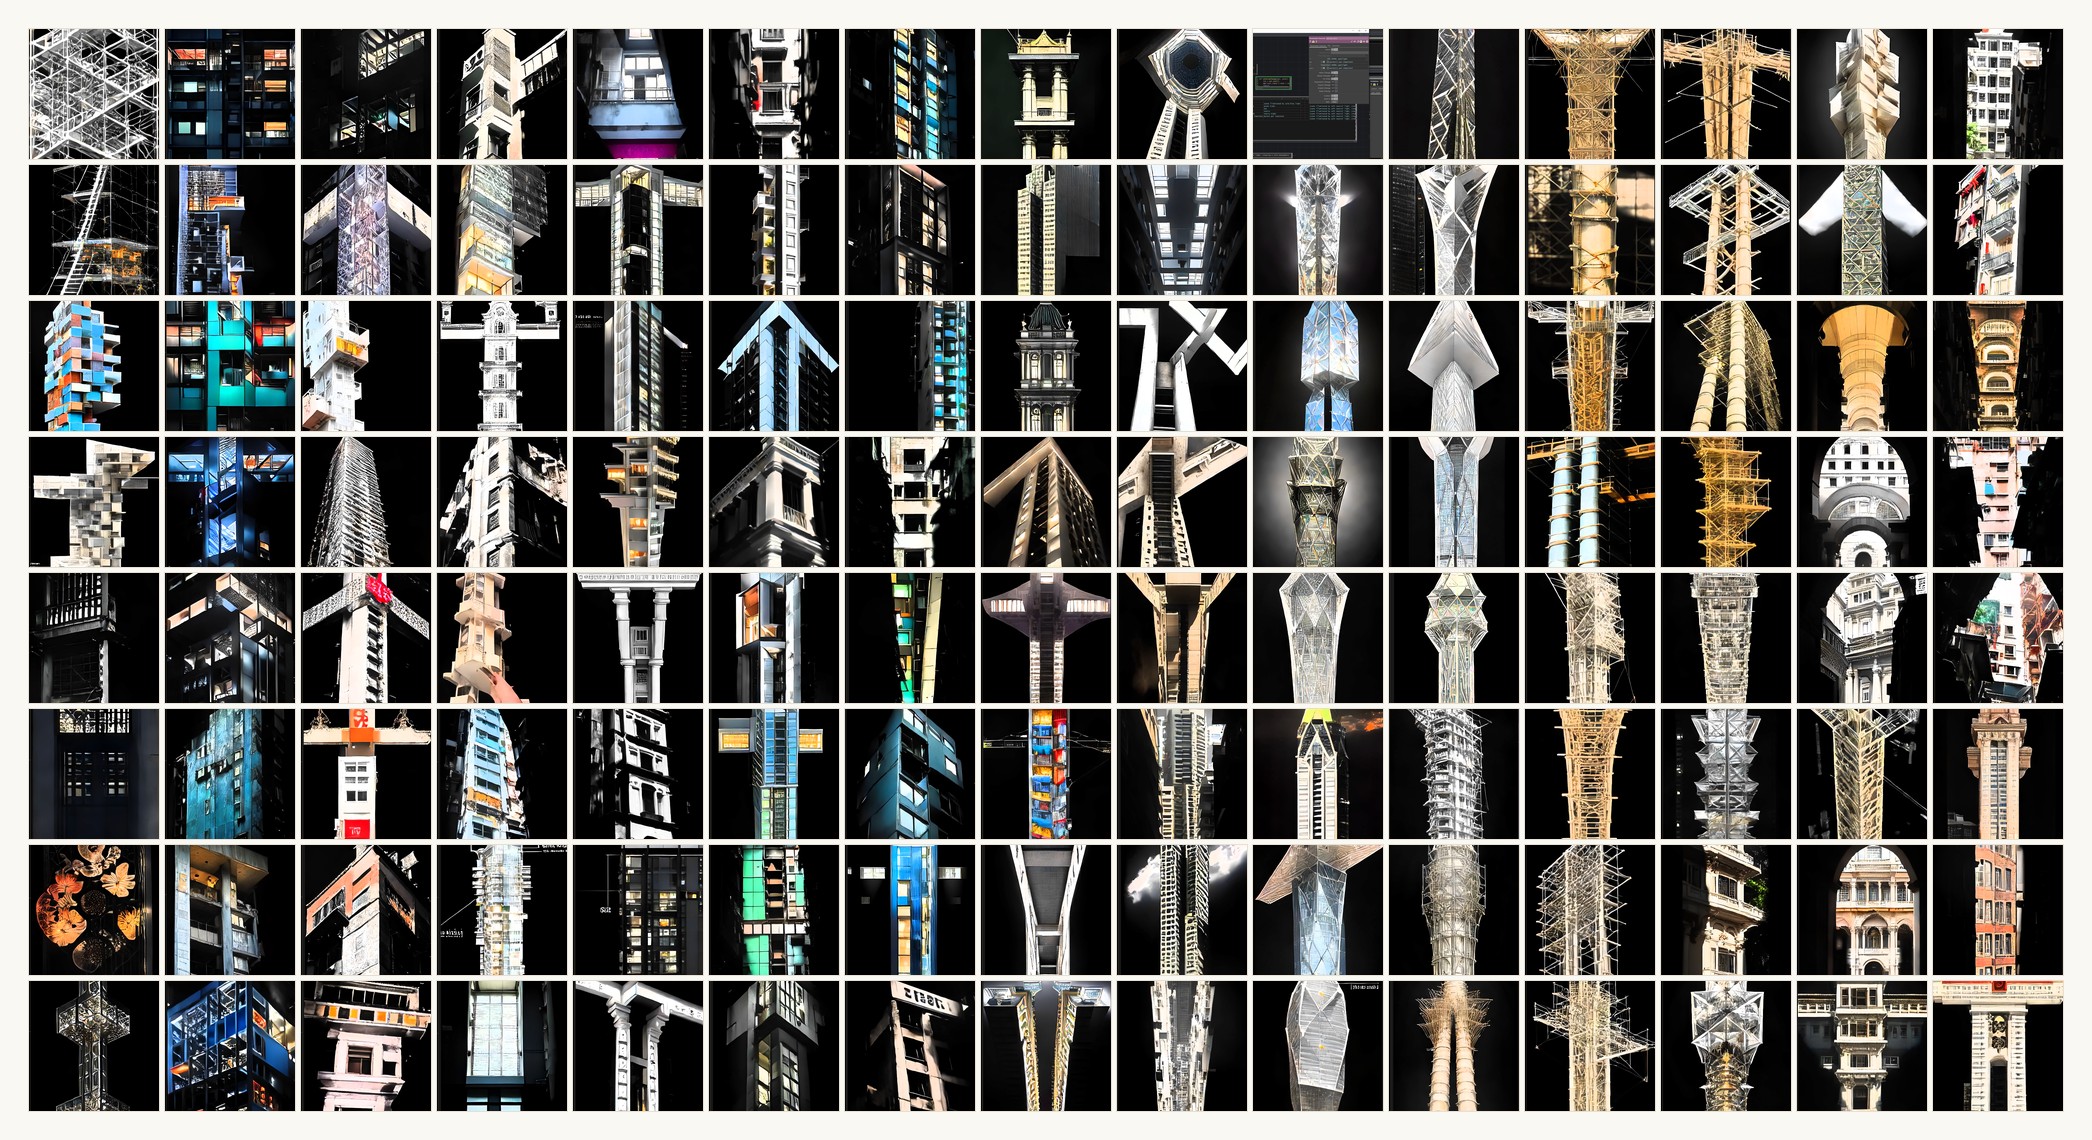
100+ 版本化迭代输出选帧 grid · 时间序 2025.10→2025.12
100+ 版本化迭代选帧 · 列序 = 时间序(2025.10→12)· 同一发光独石碑形跨材质/建筑的风格一致性实证
霓虹 Neon Sign
霓虹
Neon Sign
竹棚架 Bamboo
竹棚架
Bamboo
紙皮石 Mosaic
紙皮石
Mosaic
混凝土 Concrete
混凝土
Concrete
玻璃幕墙 Glass
玻璃幕墙
Glass
通花鐵閘 Metal Gate
通花鐵閘
Metal Gate
殖民红砖 Red Brick
殖民红砖
Red Brick
7 材质
Skin Token
5×7=35 矩阵
· 三层一致性

Real Deployment · 观众沉浸 + 双通道运行时工程

UABB 现场 / StreamDiffusionTD 运行时 / TD 管线
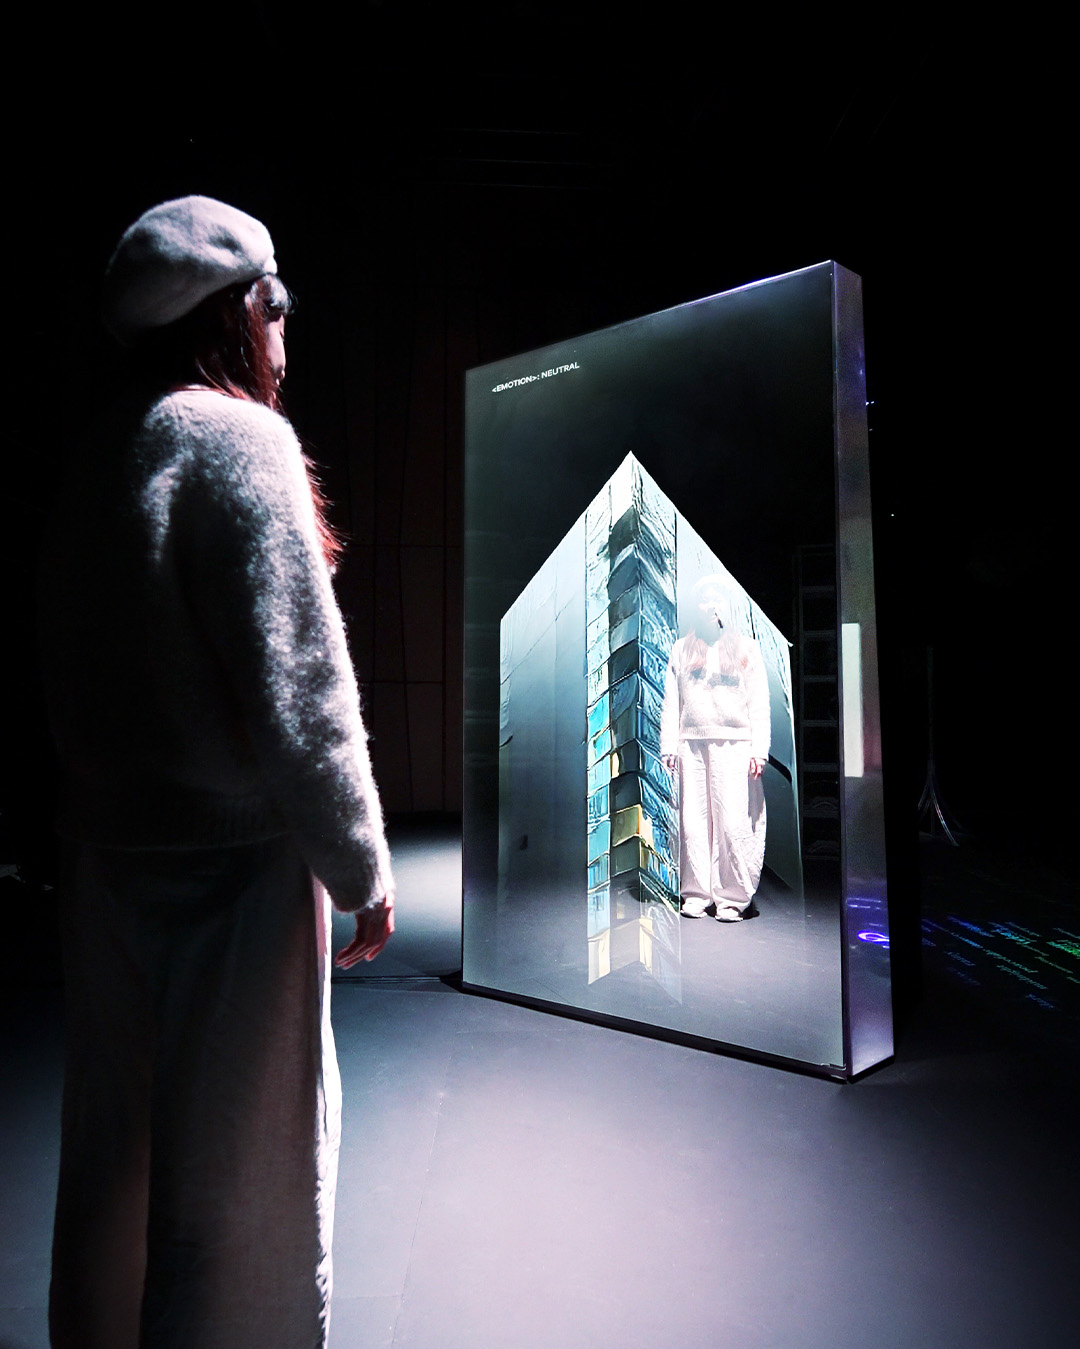
观众沉浸体验 — 单观众凝视发光独石碑屏
观众沉浸 · 凝视发光独石碑屏的人情时刻(UABB 现场)
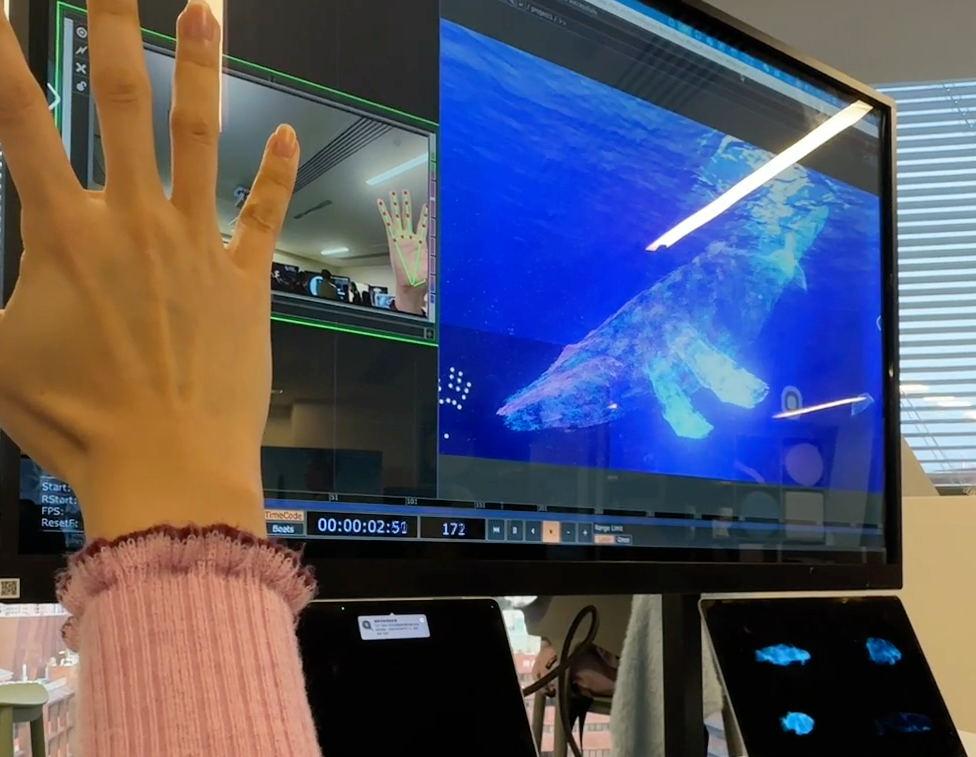
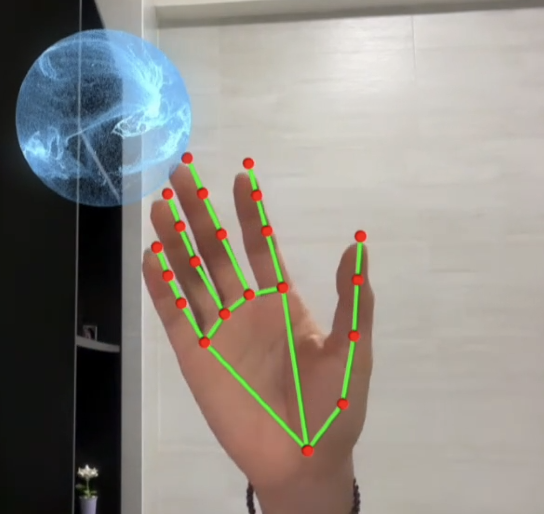
Demo Day 互动 — 观众手驱动 Material 切换实拍
Demo Day · 观众手驱动 Material 切换
运行时 输入帧 → 输出渲染 — MediaPipe input → SD output TD 节点管线 StreamDiffusionTD 引擎 — sd-turbo 1 step 29.12fps
双通道运行时 · MediaPipe 输入 → StreamDiffusionTD 输出
sd-turbo 1 step · 29.12 fps · prompt 三层加权
100+
版本化输出
5×7=35
建筑 × 材质 Prompt 矩阵
2 通道
MediaPipe → StreamDiffusionTD · UABB 现场运行时
21

复盘 · 五环叙事 / Reflection · Narrative

三层 Prompt 协议 — 让每个 AI 行为参数都附带它的决策证据

① 起点 / Situation

UABB AI 装置「眾生鏡」:v1 沿用 SDK 默认配置 → 模型先验偏差频出;策展一致性 × 观众参与 × AI 可控 三者求工程化平衡

② 约束 / Constraints

AI 行为不可控 × 集体性 vs 个体性策展张力 × 无线上 DAU 可用——三层张力同步施压

③ 关键决策 / Actions

  • 评估 LoRA 路径后主动放弃 — ROI 推导:LoRA 训练 1 风格 ≈ 数小时 GPU + 50+ 样本筛选 + 版本 diff 困难 vs Prompt 工程支持文本可读 diff + 快速修改;3 个月内 Prompt 工程可完成 5 建筑 × 7 材质全覆盖
  • 三层 Prompt 权重架构(项目独立设计 Token-as-Prompt 协议) — L1 0.30 / L2 0.40–0.45 / L3 0.15–0.30 逐套动态映射 + template 0.75× / audience 主动压到 0.25× + CFG clamp 6-7
  • 7×7 = 49 组情绪 × 材质混合调研(Google Form + 访谈) — 建立情绪→材质映射:每类情绪对应高关联度材质(窄峰聚焦 ≤ 2 情绪类别 vs 弥散 4+ 类别),作为 Emotion Pool 触发材质切换的依据
  • 6 情绪映射 × MediaPipe ≥25fps 实时切换 — 文本框输入会打断观众的沉浸感;表情识别捕捉 6 基础情绪实时切换 L2 Material Layer

④ 量化结果 / Results

0.25× 权重 · CFG 6-7 · 5×7=35 矩阵 · 7×7 情绪→材质映射 · 100+ 版本化视频 · 偏差 v3<v1 显著降 · 策展可接受度达标

⑤ 认知升级 / Reflection · Hero

AI 装置叙事不是把生成权交给用户,是把观众情感映射到一个可设计、可复盘的工程平衡上。

观众输入权重 v1 的 1.0× 主动压到 0.25×。StreamDiffusion SDK 默认 1.0× 让团队识别 AI 装置叙事的可控性边界;权重比例本身就是设计决策。Token-as-Prompt 把「用户输入」从默认信任值降级为可调设计变量 — 三层 Prompt 权重架构等效于设计系统中 Brand Token / Component Token / Context Token 分层。
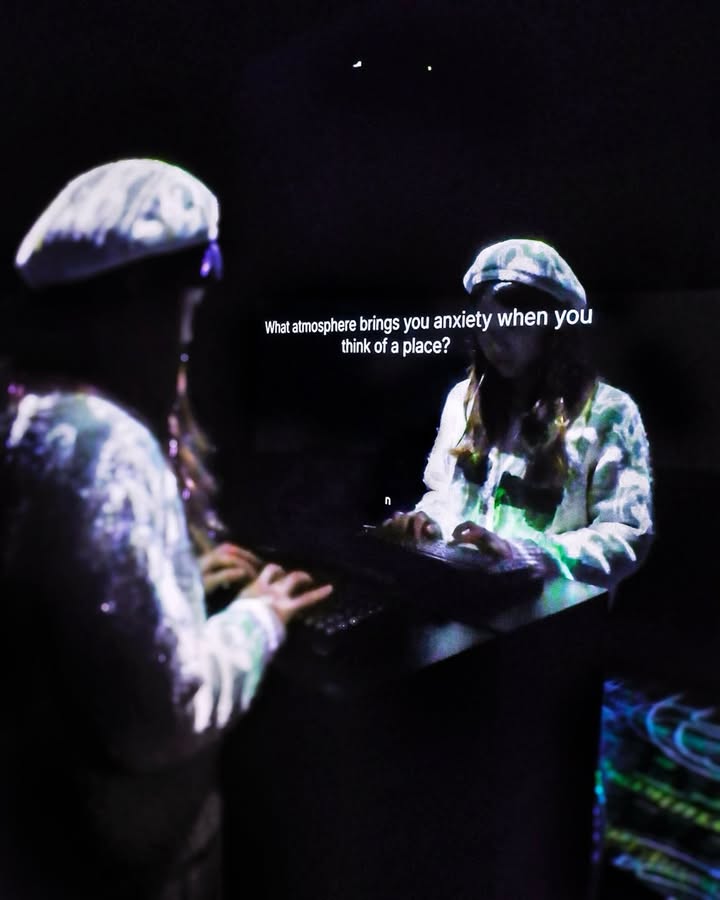
0.25×
观众输入权重 · v1 1.0× 主动压低
7×7=49
7 情绪→7 材质实时映射 · 覆盖 5 建筑(7 测选 5)
100+
版本化视频 · ≥15 份 Prompt 规范
UABB 现场 — 观众在眾生鏡装置前输入互动
UABB 现场 · 观众输入互动时刻
AI 行为参数工程化 项目独立设计 Token-as-Prompt 7×7 调研驱动决策 三层 Prompt 权重架构
22

复盘 · 验证矩阵 + 方法论 / Reflection · Matrix & Methodology

5 维验证矩阵 — 让每个「验收标准」都明示给团队

5 维验证矩阵

维度 / Dimension 方法 / Method 节奏 / Cadence 验收标准 / Acceptance
三层 Prompt 架构
探索 + 验证
v1→v3 A/B + 100+ 版本化视频对照 每轮 2-3 周 Art Team 盲测能识别 v3 vs v1 + 视觉一致性达策展可接受阈值
情绪→材质映射
探索
7×7 = 49 组 Google Form + 访谈混合调研 v3 阶段集中执行 每类情绪映射高关联材质(窄峰 ≤ 2 情绪 vs 弥散 4+ 类别)→ Emotion Pool 触发依据
AI 行为 vs 策展一致性
修复
100+ 版本化生成视频回顾归因 每轮迭代后 模型先验偏差 v3 < v1 显著下降
观众情感→视觉因果
探索
现场可用性观察 + 表情识别响应延迟 UABB 装置展出全程 观众主动尝试不同表情并能描述「我笑装置变了什么」
质性视觉反馈
质性
Art Team 盲测访谈 + 6 维度感知问卷 v3 后 反复出现「dense / layered / weathered / neon-edged」类高频词

核心收获

方法论迁移 ①

AI Prompt 系统就是一种新的设计系统

三层 Prompt 架构等效于 Brand Token / Component Token / Context Token,让我能用设计系统的工程思维去管理 AI 行为参数(版本控制、子模块复用、负面空间、跨层冗余)。

方法论迁移 ②

视觉决策可以从直觉变成数据驱动

7×7 情绪×材质混合调研扩展了我对设计师角色的理解 — 视觉决策可以从纯直觉判断延展到变量识别 + 频率统计 + 概率级结论的工程维度。

2 条核心原则

#1 先定义成功,再上线

— v1 阶段没有先定义「策展可接受的视觉一致性阈值」,v1 测试结果只能凭直觉判断,无法量化归因;v3 阶段先锁定阈值再测,决策效率提升一个数量级。

#2 没有结论也是结论

— 「为什么 v1 自由权重失败」与「为什么 v3 0.25× 成立」同等重要 — 前者直接驱动了一条工作习惯:把 SDK 初始配置当作可质疑的实测变量、而非工程出发点。

下次会做得不一样的 3 件事

①

更早做 7×7 调研 — v1 阶段先做小规模 3×3 = 9 组试点,可让权重决策有更早的数据支撑,省 2-3 周经验性试错

②

更早建立「Prompt 设计系统文档」 — FigJam 看板是末期才系统化的;v2 就建立 Token 文档结构可降低团队协作沟通成本

③

更早接入 6 情绪映射调研 — 30 组映射规范当前缺独立用户数据支撑;v3 中期做一轮观众小样本调研验证可提升规范可防御性

23
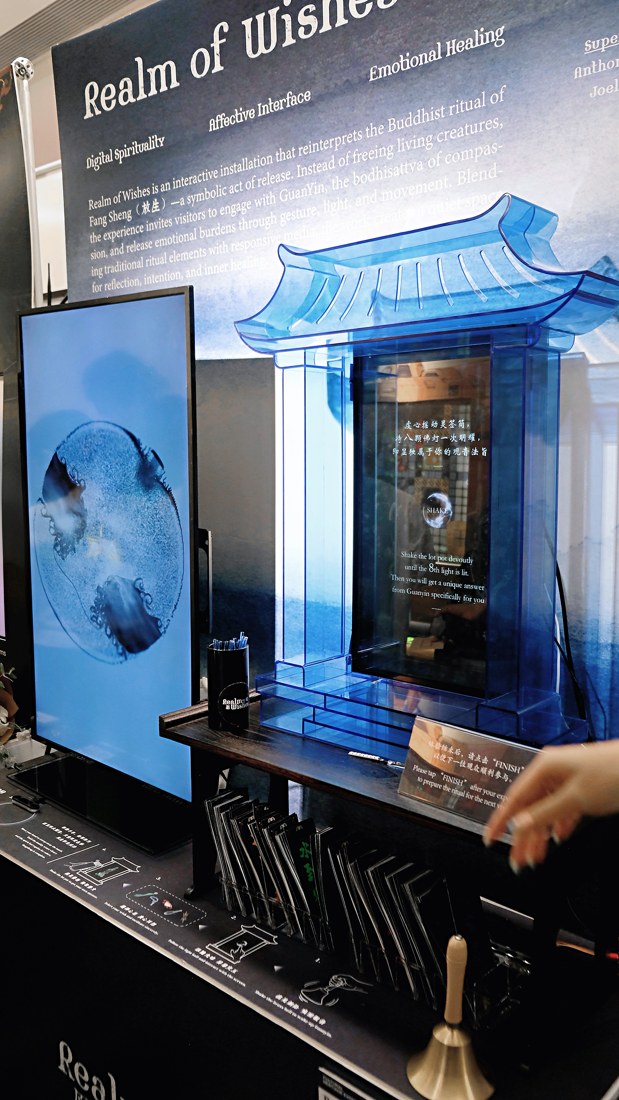
愿境主视觉 — 蓝色亚克力密闭龛内发光造像 + 现场互动(PolyU Capstone Studio 年度展)

PROJECT 01 — RESEARCH-DRIVEN DESIGNER · 用户洞察驱动

愿境 Realm of Wishes

我把 14% vs 78% 的仪式需求结构性断层主动重构为一座可独立走完的 6 段式情绪仪式装置 — V4 展后问卷 N=17 中 11/17 报告情绪释放

11/17
报告情绪释放 · V4 展后问卷 N=17(有效)
14% vs 78%
仪式实践率 vs 仪式需求 — 64 个百分点的结构性断层

核心挑战  91% 香港 Gen Z 报告与压力相关的身体或情绪症状;仅 14% 维持传统仪式实践,78% 表达「轻量级仪式」需求 — 64 个百分点的结构性断层意味着这层需求在现有供给里没有被有效承接

服务对象  现代香港都市青年(Gen Z)— 希望通过情绪释放仪式缓解焦虑,但与传统宗教渠道存在认知失调

项目立足点  用研中常被对照的数字疗愈方案(聊天机器人 / 冥想 App / 游戏化任务)不承载物理空间中的仪式重量;传统放生又面临生态与伦理争议(导致超 83 万外来物种入侵)— 两条边界共同框出「非宗教的物理仪式装置」这块工程空缺

最终成果  6 段式情绪仪式装置 — V4 展后问卷 N=17(有效):情绪释放 11/17 · 压力减轻 10/17 · 希望与乐观 9/17 · Demo Day 零崩溃 60 FPS 稳定

主导 6 段式情绪仪式弧 混合方法用研 N=15 + N=90 N=17 展后问卷量化 主动否决 V1 被动观赏路径
04
Timeline 2025.01 — 2025.07(7 个月)
My Role Research Lead & Co-Technical Implementer
Team 4 人 PolyU Capstone Studio
Type 1m×1m×2.5m 沉浸式互动装置

项目概览 / Project Overview

14% vs 78% 的仪式需求结构性断层 — 一座可独立走完的 6 段式情绪仪式装置

① Demand Gap

项目背景

2025 年初,我加入 PolyU 4 人 Capstone Studio,开启为期 7 个月的毕设项目。促使我们立项的是一组结构性数据——91% 香港 Gen Z 受访者报告与压力相关的身体或情绪症状、仅 14% 维持传统宗教仪式实践、78% 表达对「轻量级仪式」的真实需求:一边是高强度的情绪释放诉求,一边是与传统宗教渠道之间的认知失调,64 个百分点的断层意味着这层需求在现有供给里没有被有效承接。

仪式需求断层 · 全样本三分人群占比

愿境 · 仪式需求断层 14/78/8 占比 info graph N=90 双语问卷全样本三分人群:14% 传统实践派(仍维持传统宗教仪式)/ 78% 仪式需求派(想要轻量级仪式但缺承接渠道)/ 8% 中间观望派。78% 与 14% 之间 64 个百分点的落差即结构性需求断层。三段占比和 = 100%。 RITUAL DEMAND GAP · 仪式需求断层 N = 90 · 双语问卷 想要轻量级仪式的人远多于仍维持传统实践的 —— 中间 64 个百分点的需求没被现有供给承接 Δ 64 个百分点 · 结构性断层 14% 78% 8% 仪式需求派 想要轻量级仪式 · 缺承接渠道 传统实践派 TRADITIONAL 中间观望派 UNDECIDED ROOTED IN HONG KONG GEN Z RITUAL RESEARCH · 91% 报告压力相关症状
② Triple Tensions

核心挑战

三层互相牵制的张力:文化转译的双向风险(用研中约 30% 受访者对教条性宗教符号明显抗拒,但完全去除又失仪式重量)、技术性能瓶颈(CPU 粒子帧率骤降至 20-30 FPS)、仪式感与交互节奏冲突(数字交互的即时反馈节奏 vs 仪式所需的慢节奏与停顿)。
③ Method Mapping

我的应对路径

文化转译张力

研究驱动设计

性能瓶颈

GPU 重构

节奏冲突

仪式弧线框架

愿境装置全景 — 1m×1m×2.5m 蓝色亚克力沉浸式结构(屏幕 + 龛 + 底座)

装置全景 · 1m×1m×2.5m 沉浸式结构 · PolyU Capstone Studio 年度展

05

探索研究 / Research Study

N=15 深访 + N=90 问卷 + 150+ 播客 — 5 个驱动设计的核心洞察

研究对象是用户需求的结构性断层——常被对照的数字疗愈方案(聊天机器人 / 冥想 App / 游戏化任务)共享一条产品假设:「用户需要被引导着完成情绪释放」;但 14% vs 78% 之间的 64 个百分点断层意味着这条假设在某一类用户身上不成立——数据只能告诉团队「断层在哪里」,但不能告诉为什么、想要什么、能否被识别。

用研要回答的核心问题三问 / Core research questions

  1. 用户为什么有需求却不实践?
  2. 他们到底想要什么形态的仪式?
  3. 非传统仪式装置需要具备哪些设计要件,才能被用户接受为属于自己的情绪释放通道?

Mixed Methods

探索性顺序混合方法

150+ 播客 Cultural Probe 5,000+ 社媒帖子分析 15 次深度访谈 N=90 双语问卷

Phase 1 定性 =文化沉浸层 Cultural Probe(150+ 播客 + 5,000+ 社媒 / 非正式编码 / 文化语境基础)+ 正式编码层 Discourse + Thematic Analysis(30+ 篇学术文献 + 50+ 篇 NGO/媒体文章 + 14 份政策法规 + ~50 个艺术先例 + 15 次半结构化访谈 平均 36 分钟/场)。
Phase 2 定量:6 点单极 Likert 量表(去掉中间点,抑制 satisficing 偏差),以 Cronbach's α ≥ 0.70 作信度接受阈值(Tavakol & Dennick, 2011)。

在 Phase 1 文化沉浸层,AI 辅助完成了 150+ 播客转录文本的关键词聚类初筛 + 主题感性扫描(NLP 关键词提取 + 人工抽样校验 / 非 line-by-line 正式编码),将原本需 2 周的文化沉浸工作压缩至 3 天。这一实践验证了 AI 辅助用研的「效率-质量」平衡点:AI 做初筛聚类 + 人工做最终主题判断;正式 Discourse + Thematic Analysis 仍在 30+ 学术 + 50+ 媒体 + N=15 深访 corpus 上独立完成。

4 个核心洞察

洞察 1仪式感需求被压抑而非消失

14% vs 78% 断层 → 方向定为「重构」而非「替代」

洞察 2用户偏好主动掌控

91% 主动掌控偏好 + 81% 私密空间偏好 → V1 被动架构被否决

洞察 3用户要的是见证者而非权威者

「被陪伴」「被看见」「不被评判」

洞察 4手部交互比全身动作更可接受

→ 选 Leap Motion + MediaPipe

愿境 · 4 洞察 → 技术/形态决策 4 个用研洞察各落一个技术/形态决策:① 仪式感被压抑而非消失(14/78 断层)→ 做成实体交互装置而非手机 App,提供缺失的情绪承接渠道;② 用户偏好主动掌控(91% 掌控 + 81% 私密)→ 手势触发式交互、用户动作启动每一步,配单人私密场域;③ 用户要见证者而非权威者(陪伴/被看见/不评判)→ 系统即时视听回应、无评分无任务,作回应而非下达指令;④ 手部交互比全身动作更可接受 → Leap Motion + MediaPipe 近场手势 + 远场全身双通道。策略层判断(审美模糊化 / 仪式弧线 / 减速取舍)见 p27 策略推导图。 ■ INSIGHT → BUILD · 洞察→技术决策 N=15 + N=90 · 4 洞察 数据说断层在哪 · 用研说想要什么 — 每个洞察各落一个技术/形态决策 01 RESEARCH · 发现 02 BUILD · 决策 设计决策要可追溯到洞察 · 而非抱怨声量 ① 压抑非消失 14% 实践 vs 78% 想要 · App 类方案未承接 ✓ 实体交互装置(非 App) 提供缺失的情绪承接渠道 ② 主动掌控 91% 掌控 · 81% 私密 ✓ 手势触发式交互(非自动播放) 用户动作启动每一步 + 单人私密场域 ③ 见证者非权威 陪伴 / 被看见 / 不评判 ✓ 即时视听回应 · 无评分无任务 系统作回应 · 而非下达指令 ④ 手部交互可接受 手部 > 全身动作 ✓ Leap Motion + MediaPipe 近场手势 + 远场全身 双通道 ROOTED IN HONG KONG GEN Z RITUAL RESEARCH · 洞察 → 技术决策 可追溯 愿境 · 探索性顺序混合方法流程 探索性顺序混合方法设计:Phase 1 定性奠基(文化沉浸 Cultural Probe — 150+ 播客 + 5,000+ 社媒;正式编码 Discourse + Thematic — 30+ 文献 + 50+ 媒体 + 14 政策 + N=15 半结构化深访 36min/场)先建立文化语境与主题框架,经汇流进入 Phase 2 定量验证(N=90 双语问卷 · 6 点单极 Likert 去中间点抑制 satisficing · 信度阈 Cronbach’s α ≥ 0.70)。AI 辅助完成 150+ 播客关键词聚类初筛(2 周→3 天),人工做最终主题判断。 MIXED-METHODS · 混合方法 探索性顺序设计 先质性奠基 → 后量化验证 · Exploratory Sequential PHASE 1 · 定性奠基 QUALITATIVE FOUNDATION PHASE 2 · 定量验证 QUANTITATIVE VALIDATION 文化沉浸 · Cultural Probe 150+ 播客 · 5,000+ 社媒帖 非正式编码 · 文化语境基础 正式编码 · Discourse+Thematic 30+ 文献 · 50+ 媒体 · 14 政策 N=15 半结构化深访 (36m/场) 建立主题框架 → 设计量表题源 N=90 双语问卷 · Likert Scale 6 点单极 Likert 量表 去中间点 → 抑制 satisficing 验证定性洞察的普遍性 信度检验 信度阈 · Cronbach's α ≥ 0.70 Tavakol & Dennick 2011 低于阈值的维度回炉重测 奠基 → 验证 AI AI 辅助 · 效率-质量平衡点 150+播客关键词聚类初筛 (2周→3天) · 人工最终主题判断 · 独立正式编码 ROOTED IN HONG KONG GEN Z RITUAL RESEARCH · 质性奠基 + 量化验证
06

设计策略 / Design Strategy

三条策略主线 — 文化转译 × 仪式弧线 × 减速作为方法

①Spiritual Ambiguity

审美模糊化

通过粒子系统、光影、环境音效构建的「氛围神圣感」,改变用户对宗教符号的应激抗拒,达成在不被教条收编的前提下感受仪式重量。

放弃:具象神佛建模、宗教文字 · 保留:仪式行为隐喻 + 抽象粒子化视觉

②Ritual Arc

仪式弧线

通过 6 段式情绪仪式架构(触发→显现→许愿→赐福→释放→闭环),改变用户被动接受仪式的状态,达成用户成为仪式的主动驱动者。

放弃:导览式被动体验(V1)· 保留:每段有情绪目标 + 物理动作推进

③Slow Technology

减速作为方法

我把 Maister (1985) Psychology of Waiting Lines 的「占有时间 vs 空虚时间」双框架翻译为 6 段式仪式的强制物理动作设计——挥手、敲磬、摇签筒不是装饰,是把每一段过渡的等待重新分配到主动参与上。这是减速作为方法的理论根基:不只是「让用户慢下来」,是「让等待变成参与本身」。(作品集编纂期回顾性理论映射 / 详 STAR v1 附录 D-bis)

放弃:一键完成、滑动跳过 · 保留:触觉反馈 + 呼吸感停顿

愿境 · 策略推导映射图 三层推导:上层 4 个用研洞察(① 主动掌控 / ② 压抑非消失 / ③ 见证者 / ④ 手部交互)经连线映射到中层 3 条策略主线(仪式弧线 源自①② / 审美模糊化 源自②③ / 减速作为方法 源自④),再各自分叉为下层方案方向的「放弃 / 保留」取舍。策略层为视觉重心、收敛取舍对齐的判断依据。 STRATEGY DERIVATION · 策略推导 4 洞察 → 3 策略 → 取舍 ① 核心洞察 / INSIGHTS ① 主动掌控 ② 压抑非消失 ③ 见证者 ④ 手部交互 重掌控 · 私密 意愿高 · 实践低 非权威 可接受 ② 策略主线 / STRATEGIES 源自 ①② 源自 ②③ 源自 ④ 仪式弧线 审美模糊化 减速作为方法 Ritual Arc Spiritual Ambiguity Slow Technology Maister 1985 ③ 方案方向 · 取舍 / DIRECTIONS ✕ 放弃 被动导览V1 ✓ 保留 6段主动驱动 物理动作推进 ✕ 放弃 具象神佛 宗教文字 ✓ 保留 行为隐喻 抽象粒子 ✕ 放弃 一键完成 滑动跳过 ✓ 保留 触觉反馈 呼吸感停顿 策略 = 收敛 / 取舍 / 对齐 的判断依据 · 每道分叉回这三主线检验

龙王或观音、全身追踪或手部追踪、一键完成或强制物理动作——每一道分叉都反向回这三条主线检验。策略提供收敛、取舍、对齐的判断依据。

07
方案展示 I · 用户洞察驱动 / Solution I · Insight-Driven

6 段式情绪仪式弧

门槛 → 共情 → 誓愿 → 治愈 → 确认 → 反思
愿境 · 6 段交互编排谱(用户动作 × 装置回应 × 情绪目标) 交互编排矩阵:横轴 6 阶段(触发/显现/许愿/赐福/释放/闭环),竖轴 3 轨道(用户动作/装置回应/情绪目标)。列泳道由浅渐深表示仪式推进;情绪目标行实心填充为各拍的目的锚。情绪效价曲线见视觉系统页 p30。 RITUAL CHOREOGRAPHY · 交互编排 6 阶段 × 3 轨道 用户动作 USER ACTION 装置回应 SYSTEM RESPONSE 情绪目标 EMOTION GOAL 01 触发 敲击实体铜磬 系统启动 + 环境光 切入仪式调 从日常状态切离 02 显现 安静驻足 粒子「见证者」伴随 环境音浮现 感受「被看见」 03 许愿 从四象限选择 粒子聚拢成视觉锚点 主动心理承诺 04 赐福 摇晃竹制签筒 生成诗意签文 接收回应 05 释放 挥手(Leap Motion + MediaPipe) 粒子化金鱼从黯淡 进入光芒 情绪宣泄与释放 06 闭环 扫描二维码 获取实体签文 带着轻盈感离开 交互编排 = 用户动作 × 装置回应 × 情绪目标 的 6 拍编排 · 情绪效价曲线见视觉系统页

①关键决策溯源

01选观音(见证者),否龙王→ 洞察 #3
02选主动参与,否被动观赏→ 91%
03选手部追踪,否全身→ 洞察 #4
04选 6 点无中间 Likert
05选蓝色密闭龛→ 81%

②三级设计分层

策略层14% vs 78% 情感洞察 → 仪式弧架构
表现层水墨粒子 + GLSL shader + 物理交互
工程层GPU Instancing 60fps + Python DAT 状态机

③效果验证

11/17/5
仪式释放感
11/17
情绪释放
赐福段为最强正向关键时刻(MOT · Carlzon 1989)
10/17
压力减轻
08
方案展示 II · 用户洞察驱动 / Solution II · Insight-Driven

V1→V4 四轮迭代 — 主动否决被动观赏,每轮推翻一个旧判断

V1 纯被动观赏

假设视觉氛围触发仪式感 → 否定:CPU 20-30 FPS + 用户「只是在看」

V2 GPU 粒子 + 手势反馈

GPU Instancing 10,000+ 粒子 60 FPS + Noise 力场 → 状态过渡无层次

V3 状态机 + 龙王主题

状态机驱动 6 段 ✓ → 否定「龙王让我紧张」→ 洞察 #3 转向

V4 观音 + 锦鲤 + 蓝色龛

GLSL 水波纹 + Lag CHOP 滤波 → 终版落地

V1 → V4

4 轮

每轮推翻一个旧判断

GPU INSTANCING

60 FPS

10,000+ 粒子 · Noise 力场

①V1 → V4 视觉演变 / VISUAL EVOLUTION

v1上 v1下
V1 · 点云原型
v2上 v2下
V2 · GPU 粒子+手势
v3上 v3下
V3 · Gesture-Driven Visual State Machine

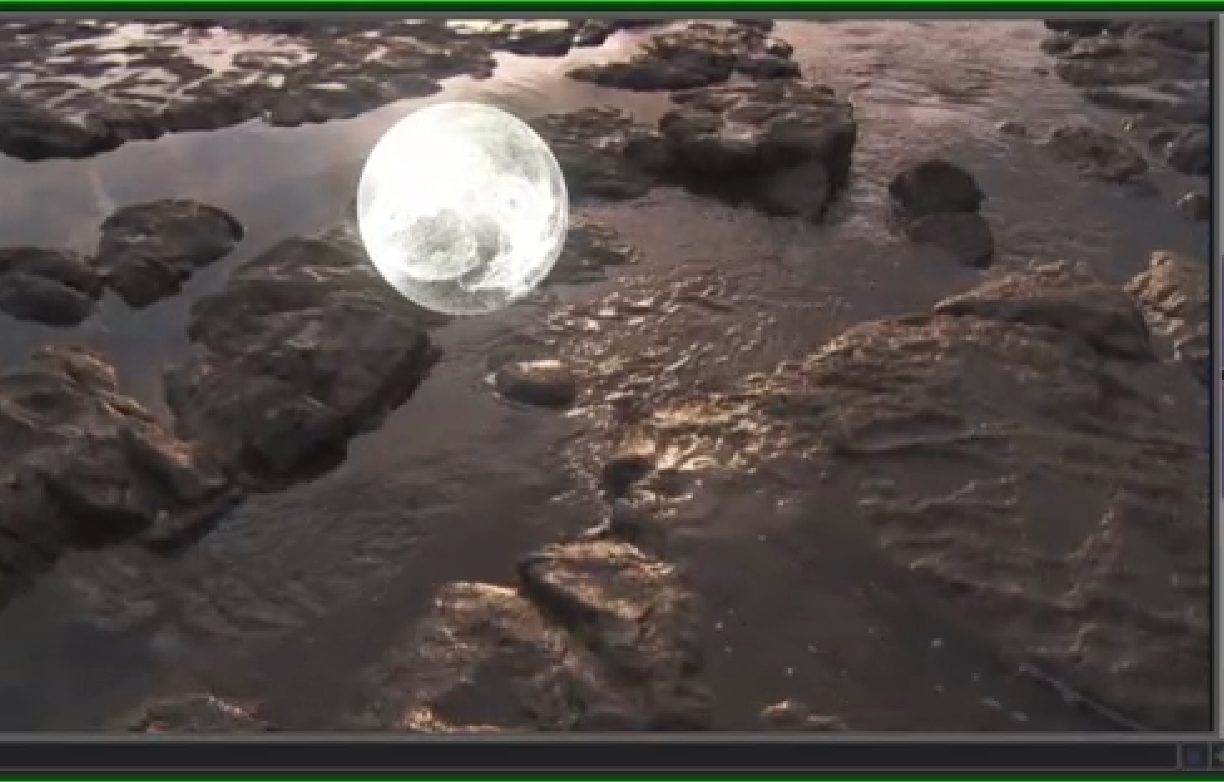
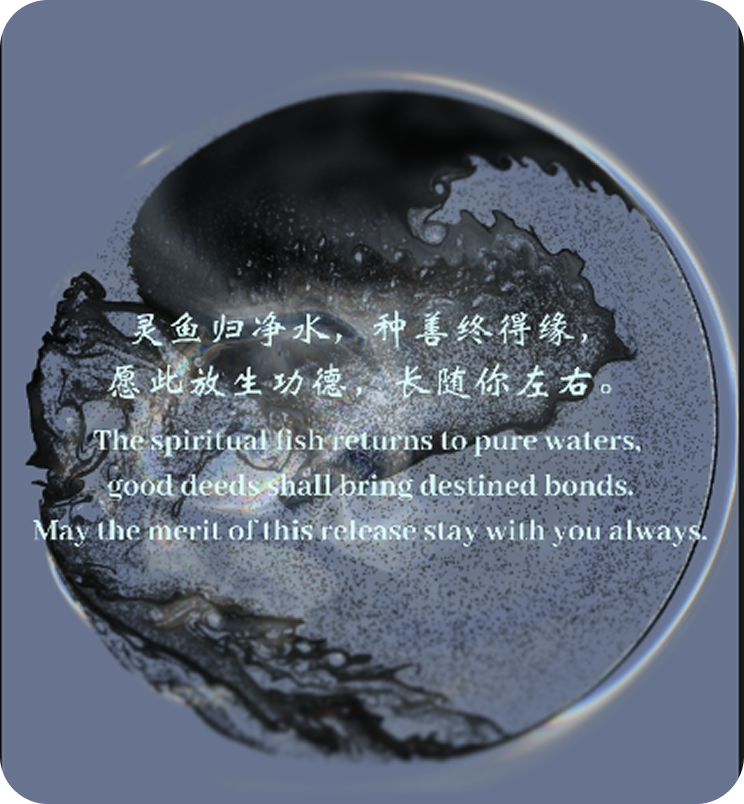
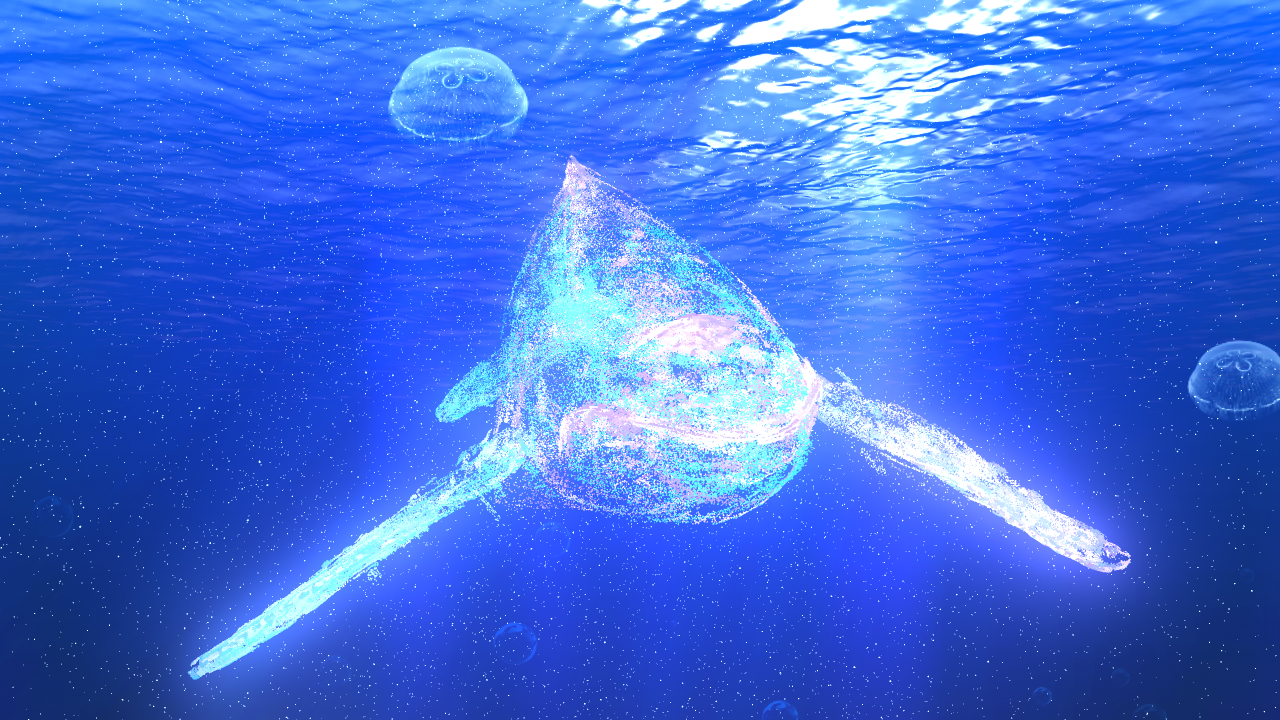
②V4 · 终版叙事弧 — 未发光 → 发光 → 转身致谢 → 水域渲染 → 放生功德

未发光态
未发光态
发光态
发光态
转身摆尾致谢
转身摆尾致谢
水域渲染
水域渲染
结束语 · 放生功德
结束语 · 放生功德
09

视觉系统 / Visual System

仪式装置的视觉系统 = 仪式弧 + 可供性 + Shader + 双通道 + 物理空间 5 层协议

把 6 段仪式弧、Norman 反馈可供性、GLSL Shader 参数、双通道手势识别、物理空间规范整合为 5 层视觉协议——可文档化、可移交、可跨展览复用。

5 子协议 · 把仪式装置写成视觉系统

①Ritual Arc

6 段情绪仪式弧

门槛 / 共情 / 誓愿 / 治愈 / 确认 / 反思——情绪强度曲线 + 双理论锚标注:Maister (1985) 占有时间 vs 空虚时间 + Carlzon (1989) MOT 服务触点关键时刻(赐福段为最强正向峰值)。把抽象的「仪式感」拆成 6 段可设计、可测试、可迭代的状态机——每段都有 entry / dwell / exit 三态,这条弧就是整套视觉系统的「时间轴」:其余 4 个子协议都沿着这 6 段铺开。

②Affordance Matrix

Norman 反馈可供性矩阵

6 段 × 三通道(visual / audio / haptic)的反馈 spec,配合物理动作目录——敲磬 / 选择 / 摇签 / 挥手 / 扫码。每个动作锚定一段仪式,每段反馈匹配 Norman Affordance × Signifier × Feedback,把「数字交互的即时节奏」与「仪式的慢节奏」桥接。

③Shader Params

GLSL 水波纹参数 + Lag 滤波

GLSL 水波纹 shader 三参数表——amplitude / frequency / decay,每段仪式有独立预设。Lag CHOP 滤波把手势抖动收敛到 7% 假阴性率,让「物理动作触发数字反馈」的连接稳定可预期。

④Dual Gesture

Leap Motion + MediaPipe 双通道

Leap Motion 近场精细手势 + MediaPipe 远场全身识别双通道架构——配合 GPU Instancing 10,000+ 粒子 60 FPS。两个识别系统在仪式弧不同段位接力,把「身体在装置中」的全过程编入视觉系统的输入层协议。

⑤Physical Spec

装置物理空间规范

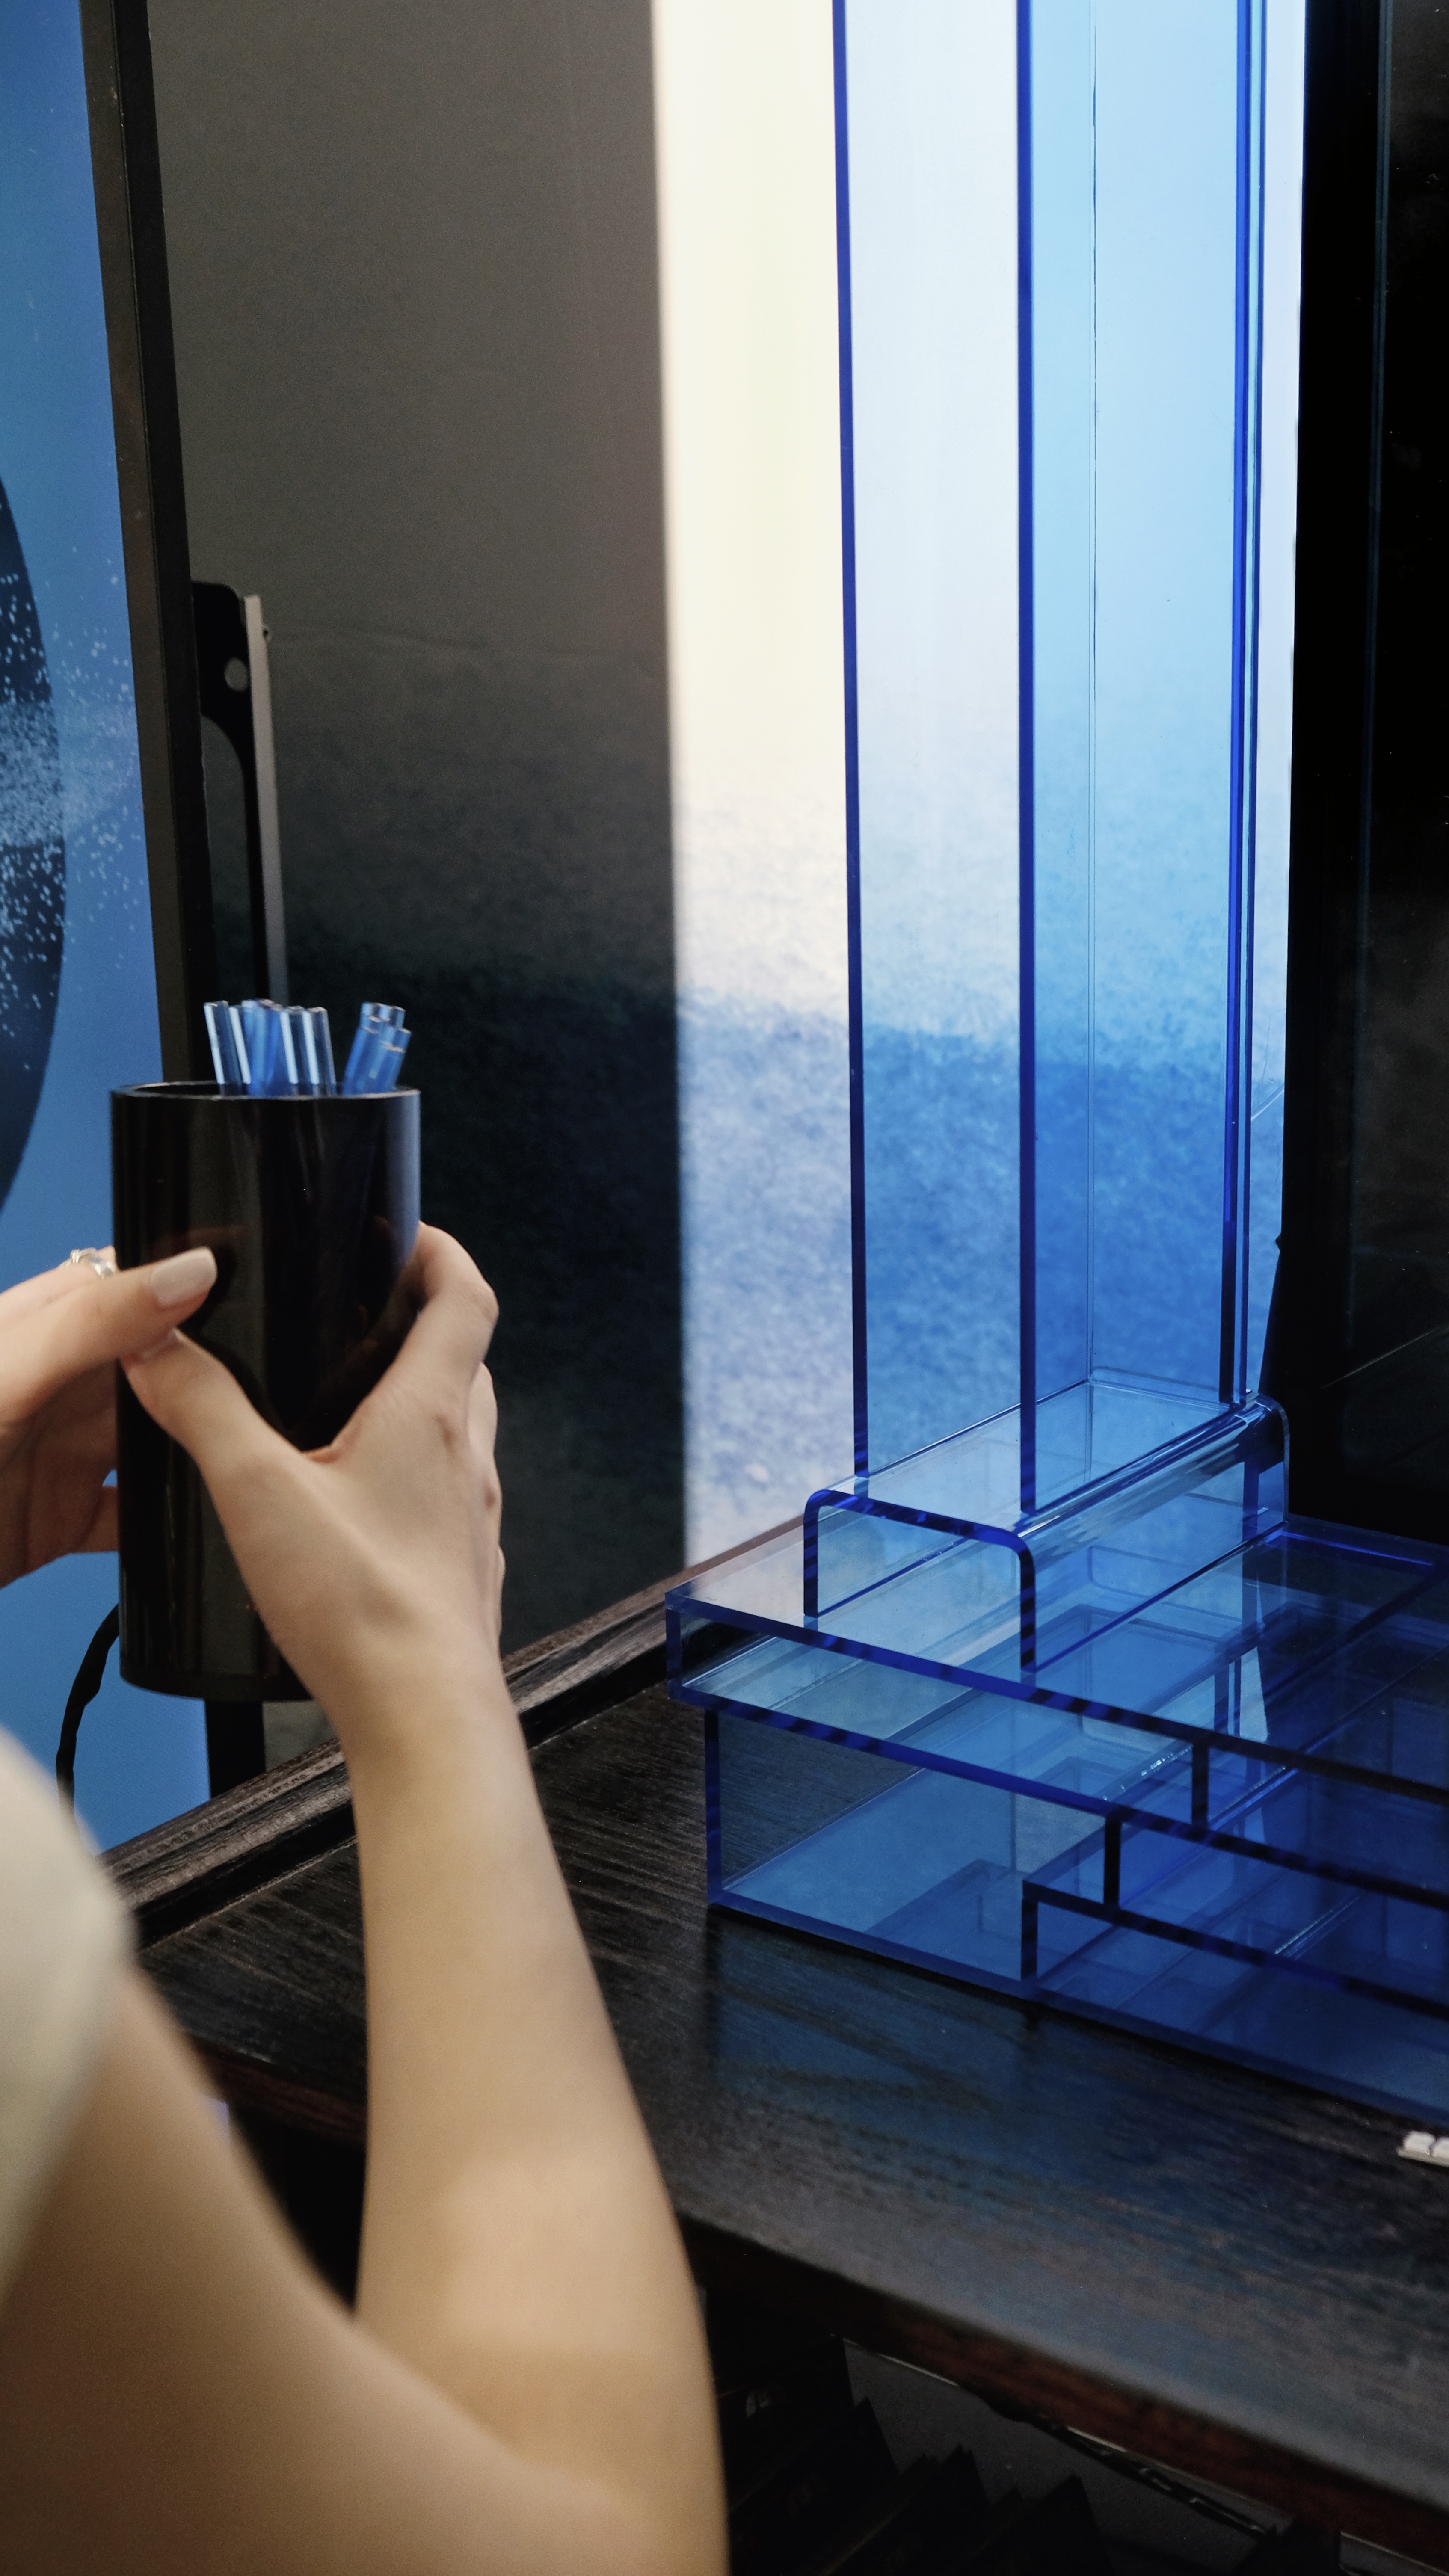
1m×1m×2.5m 蓝色亚克力密闭龛 + 4 象限许愿区 + 铜磬 + 竹签筒 + 实体签文物料——物理装置的尺寸 / 材质 / 音效 / 触觉物件都写成 spec。视觉系统不止在屏幕里,物理空间也是视觉系统的载体协议。

协议化的工程价值

可文档化

仪式弧 / 反馈矩阵 / shader 参数 / 物理 spec 均已写入 Final Report,可直接交接给团队

可跨展览

6 段弧 + 5 类物理动作可换不同文化主题(不止「许愿」)

可降级

GPU 路径退化为 CPU 兜底,shader 参数有保守预设——硬件不达标也能跑

愿境 · 6 段仪式弧 × 情绪效价 info graph V19 B33 用户旅程图(可读性收敛版):横轴为仪式时间 6 阶段(门槛/共情/誓愿/治愈/确认/反思),竖轴为情绪效价(正向/中性/负向,含中性中线)。单条仪式释放感 hero 线两次穿越中性线——门槛段「切离难」与反思段「离场茫然」为两端负效价 bookend,治愈段为 Carlzon MOT 正区顶点。每阶段一个 node dot 锚定该列,斑马列底纹让 Actions 用户动作 / Device 装置回应 / Design Strategy 设计策略 三行竖向对齐——竖读一整列即该阶段完整故事。情绪释放 11/17、压力减轻 10/17 见 legend 数值。MOT node 上方为 B70 局部精度标记(Lag CHOP 7% 假阴性)。 RITUAL ARC · 6 PHASES × EMOTION VALENCE 前期用研 N=15+90 · V4 评估 N=17 横轴 = 仪式时间 6 阶段 · 竖轴 = 情绪效价(穿越中性线)· 竖读一整列 = 该阶段完整故事 01 02 03 04 05 06 门槛 共情 誓愿 治愈 确认 反思 THRESHOLD EMPATHY PLEDGE HEALING ACTION REFLECTION ACTIONS · 用户动作 敲铜磬 驻足见证 选愿望方向 摇签筒 挥手释放 扫码取签 DEVICE · 装置回应 环境光启动 粒子见证者 粒子聚拢 屏幕签文 浑水化金鱼 实体签文 正向 中性 负向 NEUTRAL 情绪峰值 DESIGN STRATEGY · 设计策略 物质性入口 非评判 surrogate 选择降维 等待重分配 即时反馈 物质纪念 ARDUINO SLATER 1999 4 QUADRANT MAISTER 1985 NORMAN 1988 TANGIBLE ← 仪式时间 RITUAL TIME → 仪式释放感 / RITUAL RELEASE(hero 主线) V4 展后 N=17 node = 各阶段效价锚点 情绪释放 11/17 ROOTED IN HONG KONG GEN Z RITUAL RESEARCH · 91% 主动掌控 / 14% 维持传统 / 78% 想要轻量级
仪式时间、身体动作、物理空间、数字反馈用同一套视觉系统协议串起来——承接 78% 的「想要仪式但缺渠道」人群进入可独立走完的 6 段弧。
10

主视觉与现场落地 / Hero Visuals + Real Deployment

终版视觉 × 现场装置 × 用户体验 — 成品与落地

成品与现场落地 · V4 终版核心帧 / Demo Day 装置 / 用户体验实拍

PolyU Capstone Studio · 受邀 PolyU 年度设计展
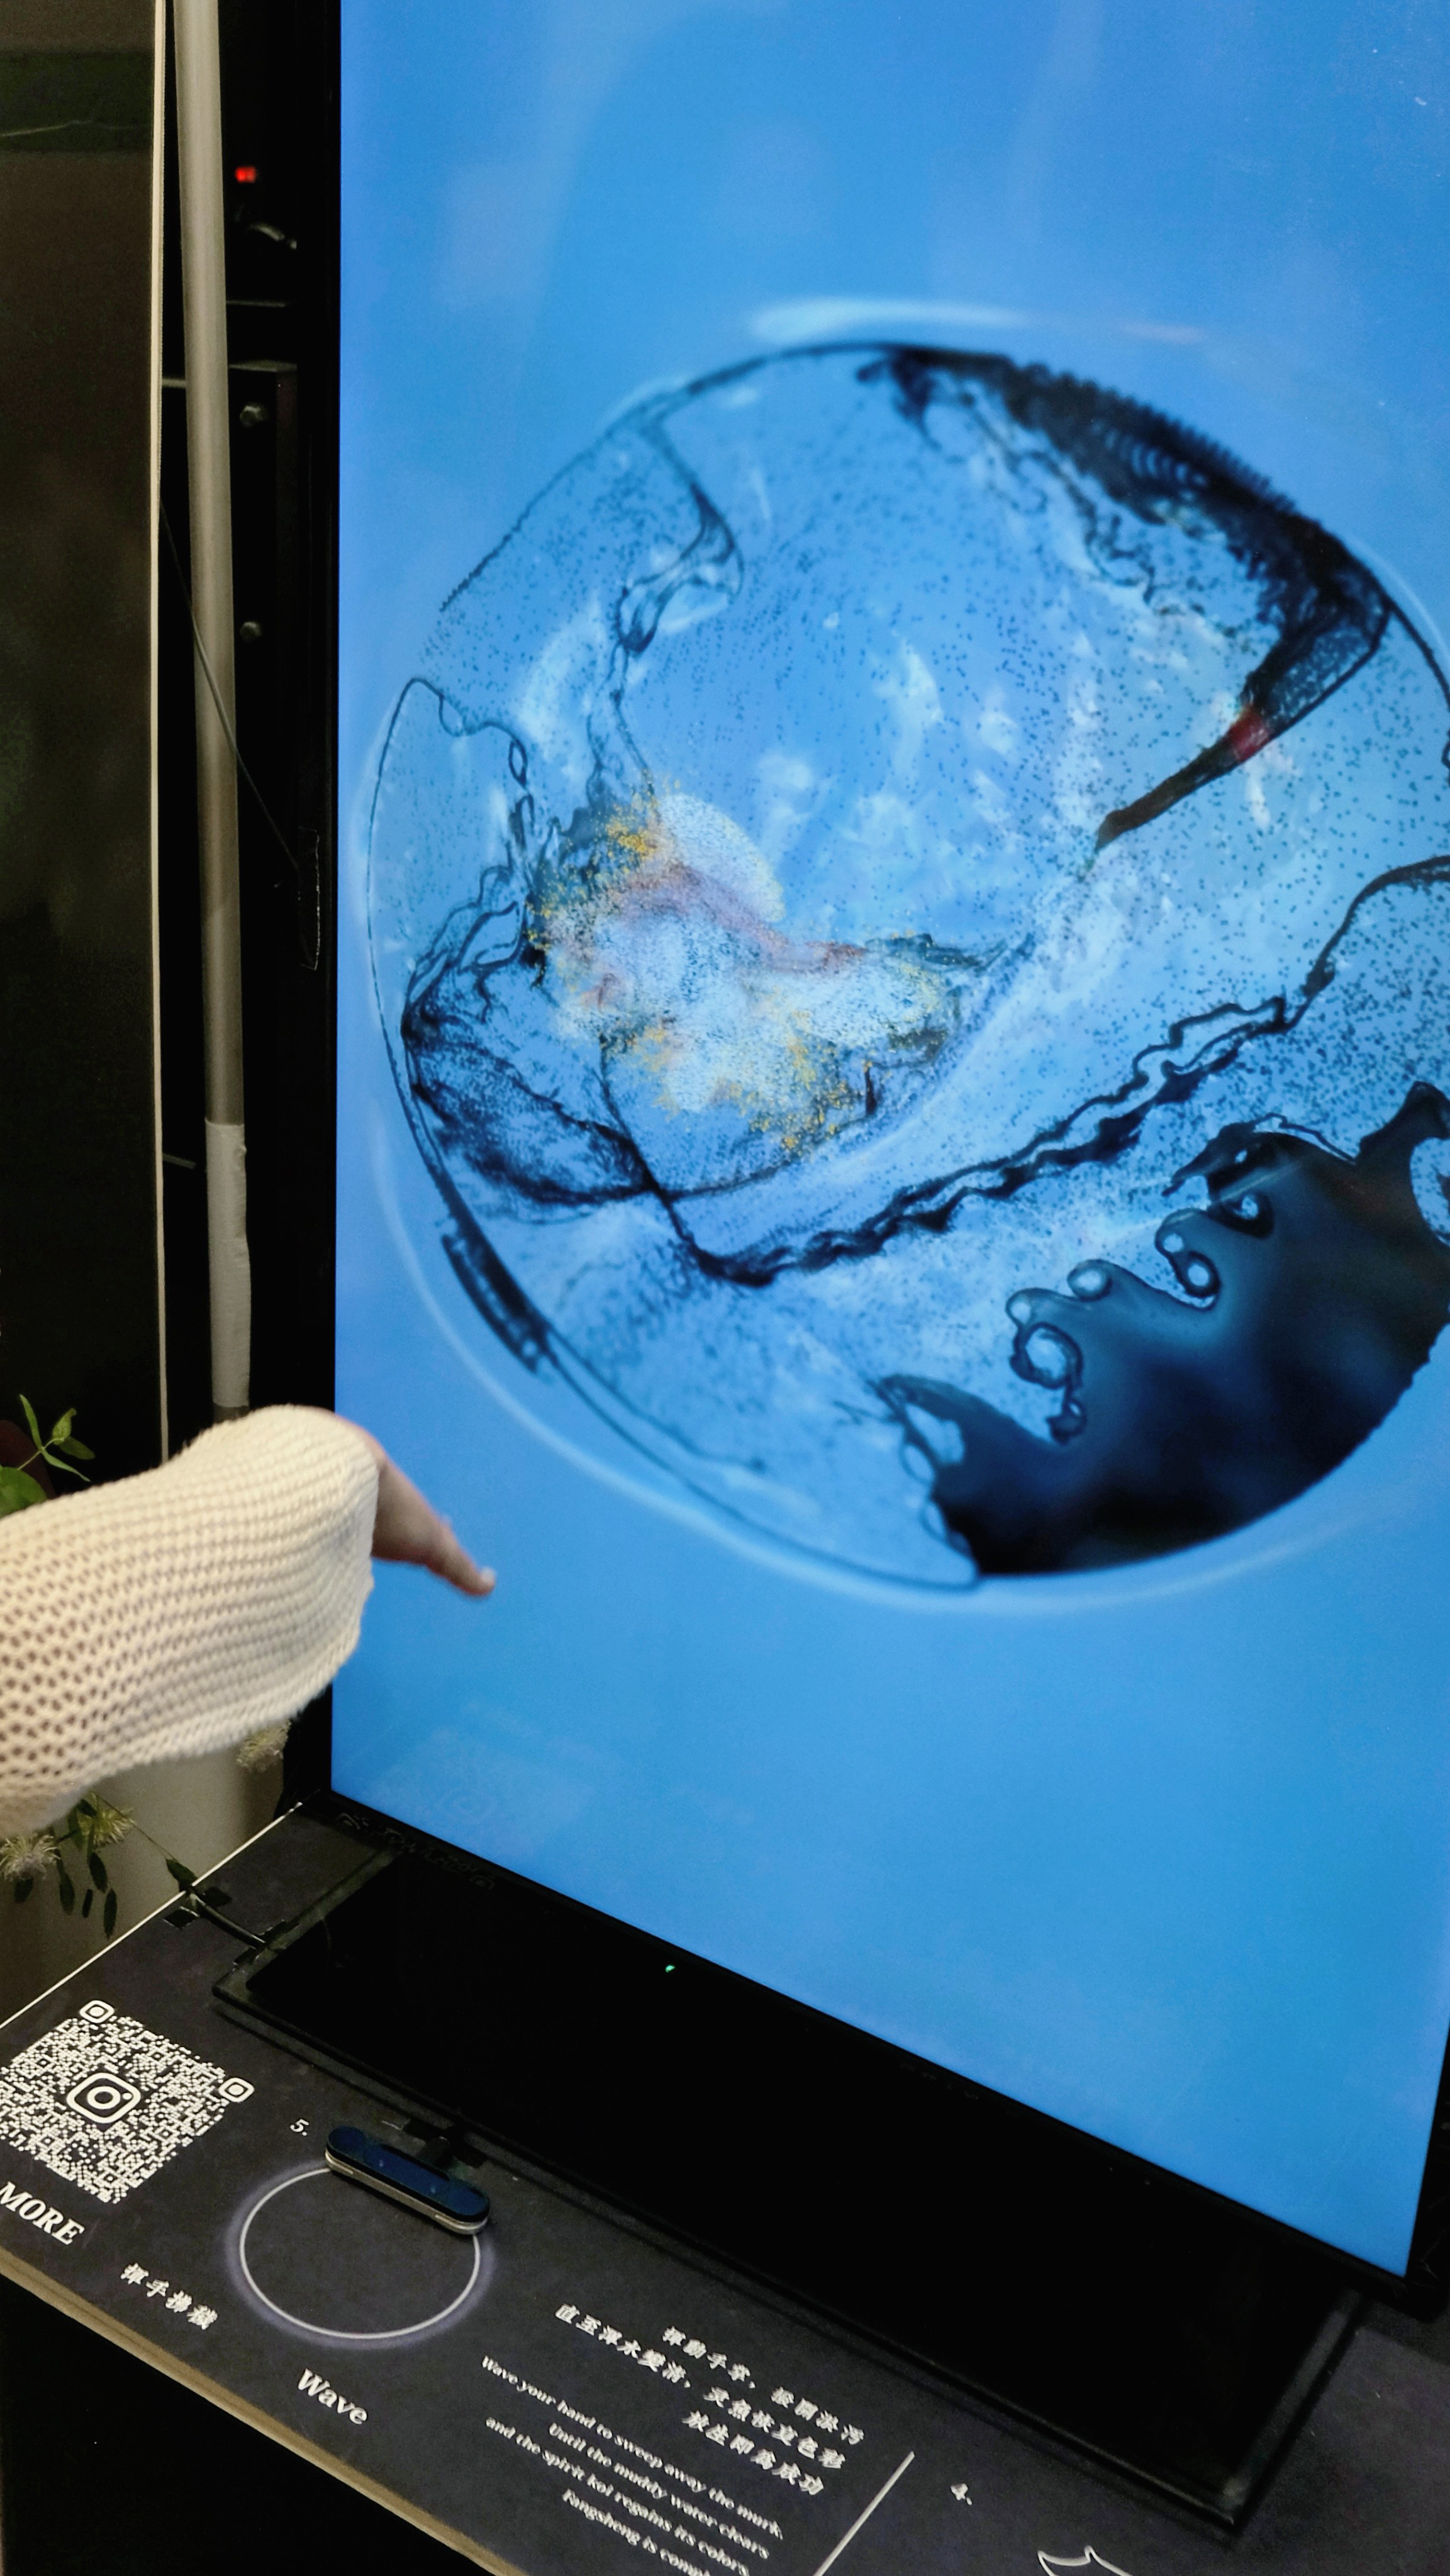
V4 终版核心帧 — 粒子化金鱼觉醒 + GLSL 水波纹 + 蓝色环境光
V4 终版核心帧 · 粒子化金鱼觉醒 + GLSL 水波纹 + 蓝色环境光
Demo Day 现场 — 蓝色亚克力密闭龛 + 用户手部触发交互
Demo Day 装置全景 · 蓝色亚克力密闭龛 + 铜磬 / 竹签筒 / 实体签文
4 个用户现场体验 — 触发 / 显现 / 许愿 / 释放
用户现场体验 · 触发 / 显现 / 许愿 / 释放
11/17
仪式感评分
10/17
压力减轻 · V4 展后 N=17
9/17
希望与乐观
60 FPS
GPU 实时性能
11

复盘 · 五环叙事 / Reflection · Narrative

6 段式情绪仪式弧 — 让每一段等待都重新分配到主动参与

① 起点 / Situation

91% 压力症状 · 14% 传统实践 vs 78% 轻量仪式需求 = 64pt 结构性断层——PolyU 4 人 Capstone · 7 个月毕设

② 约束 / Constraints

文化转译双向风险 × CPU 20-30 FPS 瓶颈 × 即时反馈 vs 仪式慢节奏——三层张力同步施压 · 无线上 DAU 可用

③ 关键决策 / Actions

  • 主动否决 V1 被动观赏路径 — 91% 用户主动掌控偏好 + 81% 私密空间偏好驱动 V2 转向 GPU Instancing 10,000+ 粒子 60 FPS + 手势反馈
  • 6 段式情绪仪式弧(团队主导设计) — 触发 → 显现 → 许愿 → 赐福 → 释放 → 闭环,每段配独立物理动作 + 情绪目标 + 装置回应三元组
  • 文化转译 = 抽离教条 + 留下隐喻 — V3「龙王」失败(用户报告紧张)→ 洞察 #3「用户要见证者而非权威者」→ V4 切换观音 + 锦鲤 + 蓝色密闭龛
  • 减速作为方法(Maister 1985 等待心理学) — 挥手 / 敲磬 / 摇签筒不是装饰,是把每段过渡的等待重新分配到主动参与;GLSL 水波纹 + Lag CHOP 滤波让手势反馈在仪式节奏内

④ 量化结果 / Results

V4 展后问卷 N=17(有效):情绪释放 11/17 · 压力减轻 10/17 · 放下内在负担 10/17 · 希望与乐观 9/17 · 相信带来好运 7/17/ 60 FPS 稳定 + Demo Day 零崩溃全天展览 / V4 假阴性率 7% / 80% 偏好水彩云朵 p<.05 / Demo Day 评估 N≈20-30 / 前期 N=15 深访 + N=90 双语问卷(以 Cronbach's α ≥ 0.70 作信度阈值)+ 文化沉浸层 150+ 播客 + 5,000+ 社媒帖子分析。

⑤ 认知升级 / Reflection · Hero

等待不是被消解的间隙,是仪式情绪被一点点垒起来的过程。
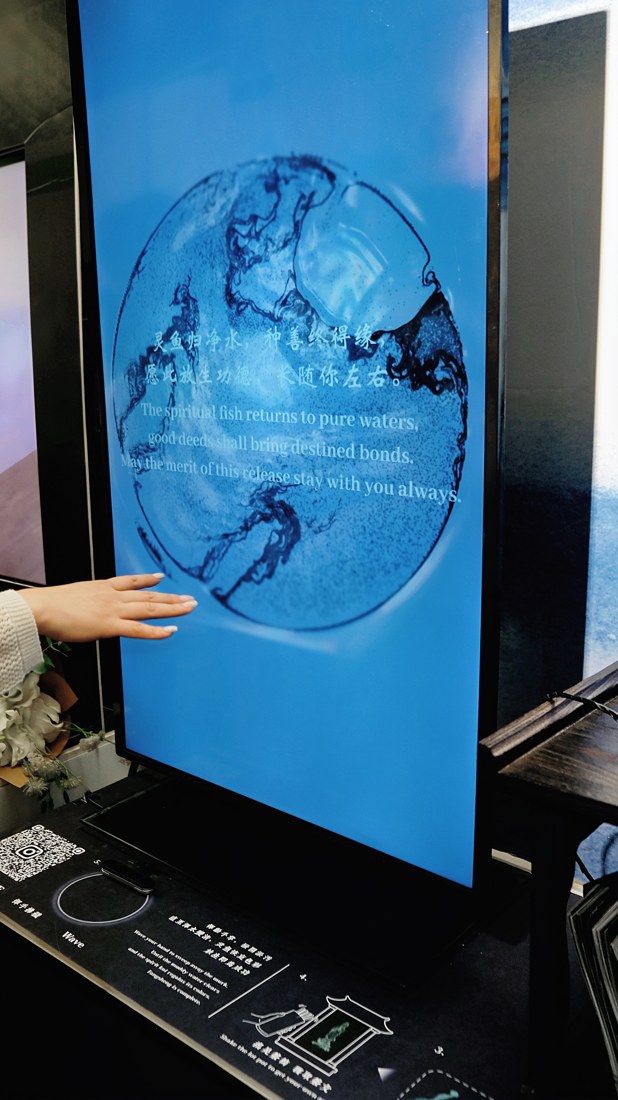
11/17
情绪释放 · V4 展后 N=17
14% vs 78%
仪式实践率 vs 需求 · 64 个百分点断层
9/17
情绪满足 · 赐福阶段最强 MOT
PolyU 年度展现场 — 用户在愿境装置前挥手交互
年度展现场 · 用户挥手交互时刻
主导 6 段式情绪仪式弧 混合方法用研 N=15 + N=90 N=17 展后问卷量化 主动否决 V1 被动观赏路径
12

复盘 · 验证矩阵 + 方法论 / Reflection · Matrix & Methodology

5 维验证矩阵 — 装置 / MVP 项目的混合验证策略

5 维验证矩阵

维度 / Dimension 方法 / Method 节奏 / Cadence 验收标准 / Acceptance
独立完成 6 段仪式
探索型
现场可用性观察 + 完成率统计 Demo Day 全程 用户在无外部协助下独立完成全 6 段流程
每轮迭代有真实增量
提升型
每版小样本可用性测试 + 访谈复盘 V1→V4 每轮 4-6 周 推翻一个旧判断 + 锁定一个新方向(例 V3→V4 龙王→观音)
量化体验质量
验证型
6 点单极 Likert(无中间)+ Cronbach's α ≥ 0.70 V4 终版 N=90 仪式释放感 ≥ 4.0/5(团队 Demo Day 前预锁阈值)
MOT 吻合度
验证型
6 阶段情绪曲线对照分析 V4 终版 「赐福」阶段为最强正向 MOT 与预设情感峰值点吻合
质性情绪反馈
质性
N=15 深访 + 用户原话访谈记录 V3 后 + Demo Day 反复出现「被治愈」「真的放下了」类母题

核心收获

方法论迁移 ①

研究的价值不是验证已有判断,而是修正它

V3 之前团队对「龙王」主题有强烈偏好(视觉冲击力强),但 N=15 访谈数据迫使切换到「做用户要的」(观音 + 见证者隐喻)— 这是 7 个月项目里最重要的设计成长。

方法论迁移 ②

文化转译 = 抽离教条 + 留下隐喻

传统文化资源完全可以服务于现代数字体验,前提是设计团队愿意做剥离与转译的功课 — 保留身体语言(敲磬 / 摇签 / 挥手)和情绪结构(仪式弧),抽离教条属性(神佛建模 / 宗教文字)。

2 条核心原则

#1 先定义成功,再上线

— 上线后再定义标准会产生自我确认偏误。团队在 Demo Day 之前就锁了 4.0/5 作为仪式释放感的成立阈值,让验证结果有可比较的基准而非事后自圆其说。

#2 没有结论也是结论

— 「为什么 V1 被动方案行不通」与「为什么 V4 主动方案成立」同等重要 — 前者直接驱动了项目从「视觉氛围能否触发仪式感」转向「仪式必须由用户主动驱动」的根本概念翻转。

下次会做得不一样的 3 件事

①

更早做物理原型 — V1 数字端验证太久(约 6 周),更早进入物理原型可省 2-3 周

②

量化更早介入 — 在 V2 就做问卷,「主动掌控偏好」数据会更早驱动决策

③

用户分群更早建立 — 14% / 78% / 8% 分群对设计同样关键,Phase 1 就应给出分群图谱

13
PolyU AI Photobooth — 毕业展互动装置现场:观众拍下屏上自己的 AI 角色,台前笔记本运行多模型生成管线(Animal Party 班级共建 LoRA 生态)

PROJECT 04 — AI SYSTEM ORCHESTRATOR · 系统编排驱动

PolyU AI Photobooth Orchestrating 6 Heterogeneous AI Models into an Exhibition-Grade Performance

在 PolyU 班级共建 LoRA 库的协作 AI 生态中,我作为 4 人团队的系统逻辑全栈,把 6 个异质 AI 模型(SD 1.5 / 4 角色 LoRA / ControlNet + OpenPose / BiRefNet)跨 3 个独立服务进程(TouchDesigner ↔ ComfyUI API ↔ PHP)编排为一套 AI 互动拍照亭,3 周 5 轮迭代内受邀参展 PolyU 年度设计展。

6 AI · 5 类
SD 1.5 × 4 角色 LoRA × ControlNet + OpenPose × BiRefNet
— 单 pipeline 内同时调度
3 周 · 5 轮
0403 → 0410 → 0417 → 0421 → Real Final
— 4 人团队 3 周 5 轮交付节奏

核心挑战  让 6 个异质 AI 模型(SD 1.5 / 4 角色 LoRA / ControlNet + OpenPose / BiRefNet)在展览现场连续运行中不连锁出错——任何一环失败都会卡死整个拍照流程

服务对象  PolyU 年度设计展现场观众(拍照体验闭环)· Animal Party 班级共建 LoRA 生态的课程协作团队

项目立足点  三个独立服务进程(TouchDesigner ↔ ComfyUI API ↔ PHP)各自无共享状态,用 TD 作指挥统一编排 + 449 行 Python 状态机(拍摄 → 审核重拍 → 存盘 → 上传)落地全部交互逻辑

最终成果  三服务隔离 × HITL Approve/Retake 人工把关——观众对 AI 输出保有判断权;3 周 5 轮迭代(0403 → 0410 → 0417 → 0421 → Real Final)受邀参展 PolyU 年度设计展

5 类 AI × 6 模型 异质编排 ComfyUI 16+ 节点 / 角色 workflow LoRA 模型级角色一致性控制 SD × ControlNet × BiRefNet 全栈 craft
34

系统编排 / System Orchestration

把一个班级共建的虚拟故事宇宙做成了展览现场可拍照的衍生 agent

这个项目从一个班级集体共建的虚拟故事宇宙里「走出来」—— SD5974 课程里我训练的角色 Maya 与同学们的角色一同进入 polyu-storyworld LoRA 库,SD5976 阶段我从这个库里选 4 个人气角色,让 PolyU 年度展观众也能「走进去」。这是 portfolio 内唯一「同时贡献 + 消费 AI 协作生态」的项目。

Role 系统逻辑全栈(TD 状态机 / ComfyUI Pipeline / API 通信 / PHP 集成 / 文档体系)
Duration 3 周 · 5 轮迭代(0403 → Real Final)
Team Animal Party · 4 人(视觉素材 = 队友;角色外形 = 班级共建 LoRA 贡献者)
Course SD5976 — AI Tools for Creative Process · PolyU 年度设计展(受邀)

系统架构三层 · 三服务进程隔离

Layer 1 · TouchDesigner(编排器)

前端交互层

5 步状态机 · PhotoBooth Python Extension · Panel 缓存 · 倒计时 UI · 4 连拍 · 角色自动轮换(以上全部模块我独立构建)

↓ HTTP API(workflow JSON · 状态轮询)

Layer 2 · ComfyUI(独立后端服务)

AI 生成层

SD 1.5 → LoRA 切换(4 角色)→ ControlNet + OpenPose 姿态注入 → BiRefNet 透明输出 · 16+ nodes/角色(Multi-Pose 4 分支并行 60+ nodes)

↓ HTTP POST(合影图像)

Layer 3 · PHP(独立上传服务)

上传分享层

photobooth_uploader.php · share.php · 合影服务器存储 + 分享链接生成(观众扫码带走)

三服务进程隔离 = 任一层故障不连锁。portfolio 内唯一「多进程跨服务 AI 集成」工程范式,与眾生鏡 in-process StreamDiffusion 形成「两种 AI 集成范式」对照。

4 步交互 Pipeline · 用户视角

① 选角色 — TD UI 展示 4 个 LoRA 角色预览卡

② AI 生成 — ComfyUI 后台 · 4 角色 × 4 姿态 Multi-Pose 并行

③ 实时拍照 + 审核重拍 — 倒计时 4 连拍 · Approve/Retake 把 AI 输出判断权还给观众

④ 合成上传 — TD Compositor Over Blend + PHP 上传 · 扫码带走合影

Storyworld 上下文 · 项目诞生背景

AI Photobooth 是横跨两门 PolyU 课程协作生态的衍生 agent:
SD5974(上游):我完成角色 Maya(月光图书馆学徒 / 8432g.yaml)设计并贡献入班级共建 LoRA 库(polyu-storyworld)。
SD5976(汇流):班级 LoRA 库已有 N 位同学贡献的角色 → AI Photobooth 从中评估筛选 4 个人气角色集成。

我同时是 LoRA 协作生态的贡献者(训练 Maya 入库)和消费者(从他人贡献的库中选型 4 角色集成)。
35

选型研究 / Selection Research

选「哪些 AI 协同」+ 选「怎么协同」= 这次研究的两条主轴

Round 2 那一周我做了两件事:从班级 LoRA 库所有已贡献候选中按 4 维评分筛出 4 角色(约束 1 协作生态的具体落地);同周用 img2img 验证姿态迁移、撞到「污染 LoRA 特征」边界后换为 ControlNet+OpenPose(约束 2 展览可靠性的工程取舍)。这种约束驱动的选型研究范式是 portfolio 内唯一的「AI 系统选型研究」,与三 hero 的图像学研究 / 场所精神研究 / 混合用研形成研究方法论矩阵。

三层约束分析(研究起点)

①Collaboration Ecosystem

协作生态约束

班级共建 LoRA 库已存在 → 选型集成而非重新训练。协作结构反向决定技术架构 — 班级共建生态决定「LoRA 选型」而非「Prompt 工程」(Conway's Law 逆用)

②Field Reliability

现场可靠性约束

不可控展览环境 + 陌生用户 + 高频操作 → 故障不连锁是展览当天唯一硬性 KPI。服务化架构 + 关注点分离(SOA + SoC)

③Delivery Cadence

团队交付节奏约束

3 周 / 4 人 / 我独立承担系统逻辑全栈 → 技术路径都得在 3 周内实现并稳定。自建 vs 复用

三个核心选型研究问题

Q1 — 如何在多角色场景下保持角色视觉一致性?

评估了 Prompt 工程化 / Textual Inversion / DreamBooth / LoRA 模型级锁定

✓ LoRA strength 1.0 — 模型权重层角色特征内嵌,不依赖 Prompt

Q2 — 如何在保持角色特征的同时控制不同观众的姿态?

评估了 Prompt 描述 / img2img / IP-Adapter / ControlNet+OpenPose

✓ ControlNet+OpenPose — OpenPose 只传骨架,LoRA 独立管理外观(SoC)

Q3 — 如何在三服务间实现可靠的跨进程通信?

评估了 diffusers in-process / TD StreamDiffusion COMP / ComfyUI Embedded / API 模式

✓ ComfyUI API 模式 + PHP 独立服务 — 三层完整进程隔离

四项核心洞察

洞察 1

模型层身份绑定 — 角色一致性下沉到权重

Identity binding at model layer

洞察 2

关注点分离 — 骨架与外观各管各的

Separation of Concerns (SoC)

洞察 3

服务化架构 — 三服务故障不连锁

Service-Oriented Architecture (SOA)

洞察 4

多模型编排 — 每个子任务配一个专职 AI

Multi-Model Orchestration
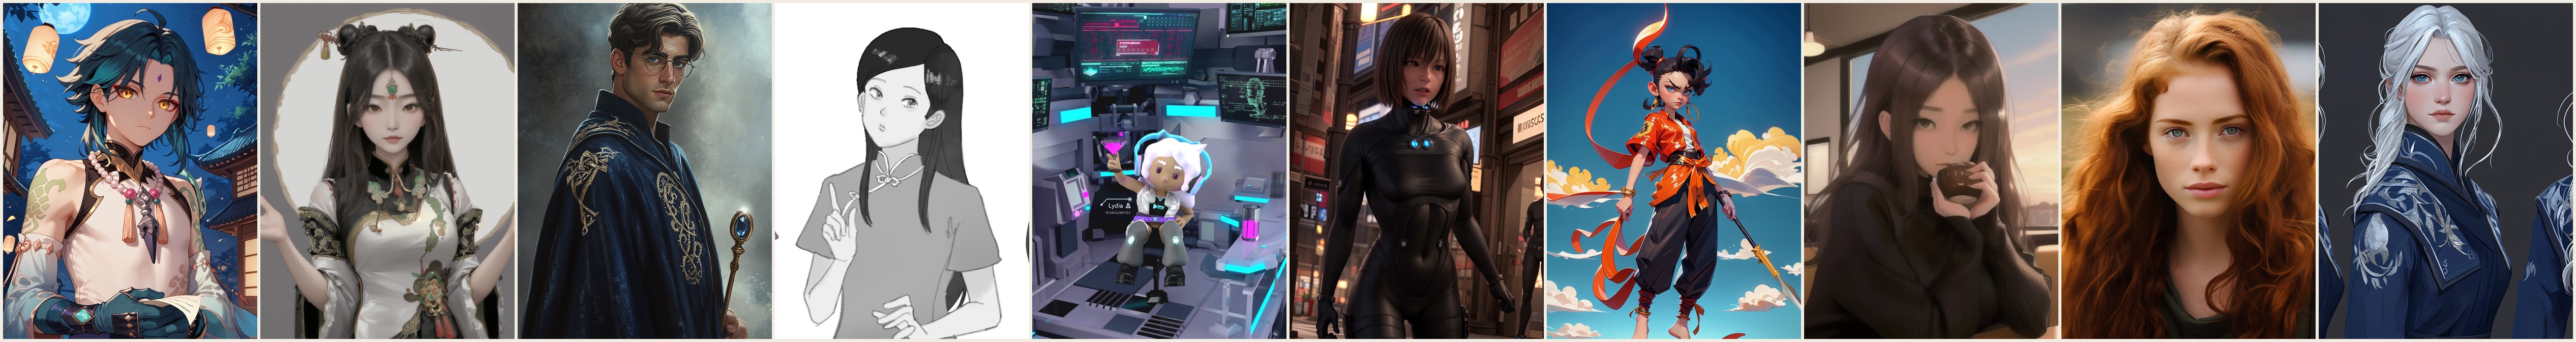
班级共建 LoRA 库角色集 — 同学贡献的 10+ 多角色生成,按 4 维评分筛选 4 角色集成进 photobooth
班级共建 LoRA 库角色集 · 同学多风格贡献 → 4 维评分筛选 4 角色集成进 photobooth(dataset specimen)
36
设计策略 / Design Strategy

编排多模型 AI 系统的 3 个工程决策:服务隔离、生态选型、人工把关

PolyU · 约束到策略推导带 两层推导:上层 p37 三层约束(协作生态 / 现场可靠性 / 交付节奏),经对称直线推导到下层三个工程决策(服务化架构 源自约束② / LoRA 生态选型 源自约束①③ / 现场容错设计 源自约束②),三个决策垂直对位下方三张策略详解卡。§T 映射 · V3 · 源: p37 三层约束 → 本页 3 策略卡。 STRATEGY DERIVATION · 策略推导 ① 协作生态约束 班级 LoRA 库已存在 → 选型集成 ② 现场可靠性约束 故障不连锁 = 展览当天硬性 KPI ③ 交付节奏约束 3 周 · 4 人 · 系统逻辑独立承担 服务化架构 LoRA 生态选型 现场容错设计

①SOA + SoC

源自 约束②

服务化架构

TD 编排的三层 AI 服务架构

拒绝单体集成,改用三层独立服务 + API 编排:TD 编排 ComfyUI AI 后端 + PHP 存储服务,三层通过 HTTP API 通信。

● ComfyUI --listen API 模式 → TD Python HTTP 调用
● 三层均有独立日志 + 异常捕获 → 任一层可独立重启
● 约束 2 × 约束 3 的交集:隔离 + 可调试

理论支点:服务化架构 + 关注点分离

任一服务故障 fail-fast 而不连锁 — 现场可靠性约束的直接工程解法

②Conway's Law 逆用

源自 约束①③

LoRA 模型级角色控制

从协作生态选型而非从头训练

不重新训练专属 LoRA,从 polyu-storyworld 班级共建库评估筛选 4 个最具视觉辨识度的人气角色,strength = 1.0。

● 4 维选型框架:视觉辨识度 / 训练质量 / 多样性 / 班级代表性
● 开发周期缩短至少 1 周(自建 vs 复用)
● 我同时是贡献者(Maya 入库)+ 消费者(4 角色集成)

理论支点:让架构反映协作生态

让项目真正成为 Storyworld 生态的衍生 agent,而非孤立 AI 系统

③Human-in-the-Loop

源自 约束②

现场容错设计

5 步状态机 + HITL 介入点 + 多层防错

5 步状态机(Start → Capture → Approve/Retake → Combine → Upload)+ Python 层异常捕获全覆盖 + 60+ 版本快照回退。

● Approve/Retake = AI 输出主观判断权精确归还用户
● 任意步骤出错 → 状态机自动回退 Start
● Panel 缓存管理防 UI 闪烁(展览高频操作)

理论支点:人工把关点

HITL 介入点的物理实现 — 线性流程升级为有回路的容错流程
37
ComfyUI 工作流 / ComfyUI Workflow

让单个 ComfyUI workflow 编排 6 个异质 AI 协同出图 — 60+ 节点的多模型调度切片

①单角色 workflow 节点结构(16+ nodes)

CheckpointLoader: v1-5-pruned.safetensors
↓
LoRALoader: {角色}.safetensors, strength=1.0
↓
CLIPTextEncode: Positive + Negative Prompt
↓
ControlNet + OpenPose 骨架注入
↓
KSampler: 20 steps · CFG 8.15 · Euler · denoise 0.69
↓
VAEDecode → SaveImage
↓
BiRefNet RMBG: 语义分割背景移除
↓
透明 PNG → TD characterCompositor Over blend

②KSampler 关键参数决策

参数 锁定值 决策理由
Steps20≈ 3-5 秒/图,被倒计时 UI 吸收
CFG8.15增强 LoRA 遵从度,实测稳定点
SamplerEulerSD 1.5 + LoRA 兼容性最佳
Denoise0.69结构与外观均保留的实测平衡点

③BiRefNet — 合成 pipeline 最后一层

SD 生成图像始终带背景 (无法生成真正透明 PNG)。

BiRefNet(RMBG)语义感知分割对 anime/illustration 风格边缘(发丝 / 服装纹理)处理精度优于传统算法,输出透明 PNG 直接用于 TD characterCompositor Over blend 合成。
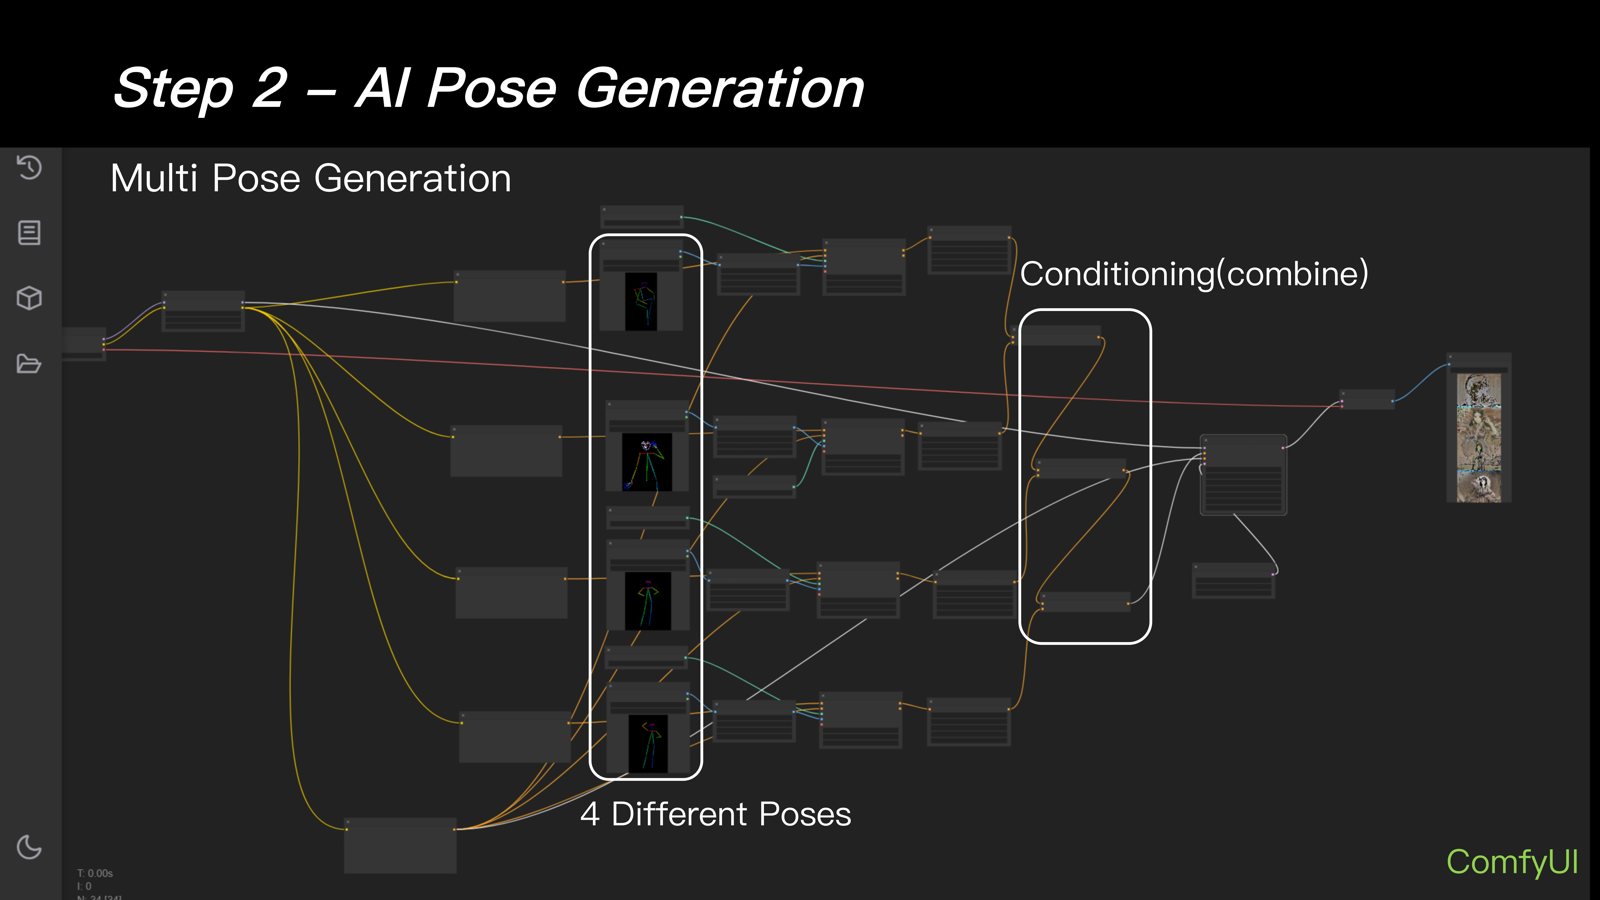
ComfyUI Multi-Pose 4 分支并行 workflow — 4 姿态 OpenPose 输入 → Conditioning Combine → 4 Different Poses 并行生成
ComfyUI 实景 · Multi-Pose 4 分支 → Conditioning Combine → 4 姿态并行生成

Multi-Pose 4 分支并行生成架构

[姿态 1] → OpenPose → ControlNet ─┐
[姿态 2] → OpenPose → ControlNet ─┤ Conditioning Combine
[姿态 3] → OpenPose → ControlNet ─┤ → KSampler batch=4
[姿态 4] → OpenPose → ControlNet ─┘ → BiRefNet ×4

LoRA 生态参与 · 双重角色

贡献者

SD5974 训练 Maya(8432g.yaml)贡献入 polyu-storyworld 库

消费者

SD5976 从库中 4 维评估筛选 4 个人气角色集成进 photobooth

节点数

60+

4 分支并行

单次输出

4 张

不同姿态合影

38
TD 交互系统 / TD Interaction

让一个 AI 互动装置在 3 周内从原型走到展厅可独立运行

4 人团队 / 3 周交付 / 我独立承担系统逻辑全栈 —— 这意味着既要快出原型,又要让队友能在我交付的代码上继续推进。PhotoBooth Extension + API 通信 + 5 轮迭代 + 文档体系,是同时满足这两个目标的工程切片。

①PhotoBooth Python Extension · 449 行状态机(我独立设计与实现)

class PhotoBooth:
"""5-step state machine for AI Photobooth interaction flow"""
STATES = ['Start', 'Capture', 'Approve', 'Combine', 'Upload']
# 状态切换核心方法
def Step1_Start(self): ... # 角色选择 → LoRA 切换
def Step2_Capture(self): ... # 倒计时 + 4 连拍 + 角色自动轮换
def Step3_Approve(self): ... # HITL 介入点
def Step4_Combine(self): ... # characterCompositor 实时叠加
def Step5_Upload(self): ... # PHP API 上传 + 分享链接
# HITL 分支方法
def ApprovePhoto(self, idx): ... # 保留分支 → 进入下张或合成
def RetakePhoto(self, idx): ... # 重拍分支 → 回退到对应拍摄帧
# 容错与诊断
def Debug(self): ... # 错误状态诊断方法
def Reset(self): ... # 异常回退到 Start

②TD ↔ ComfyUI HTTP API 通信(6 步协议)

[1] TD 读取对应角色 workflow JSON 模板

[2] 替换 workflow JSON LoRA 节点 ID = 当前选中角色

[3] POST → ComfyUI /prompt(带 workflow JSON)

[4] 轮询 /queue 状态 → 等待生成完成(≈ 10-15 秒)

[5] 下载 4 张透明 PNG → TD 本地

[6] characterCompositor → 4 张合影 → PHP 上传 + 分享链接

③完整工程文档体系

README.md

完整安装 / 运行指南

setup guide

环境配置文档

extension docs

PhotoBooth API 文档

CHANGELOG

5 轮迭代变更记录
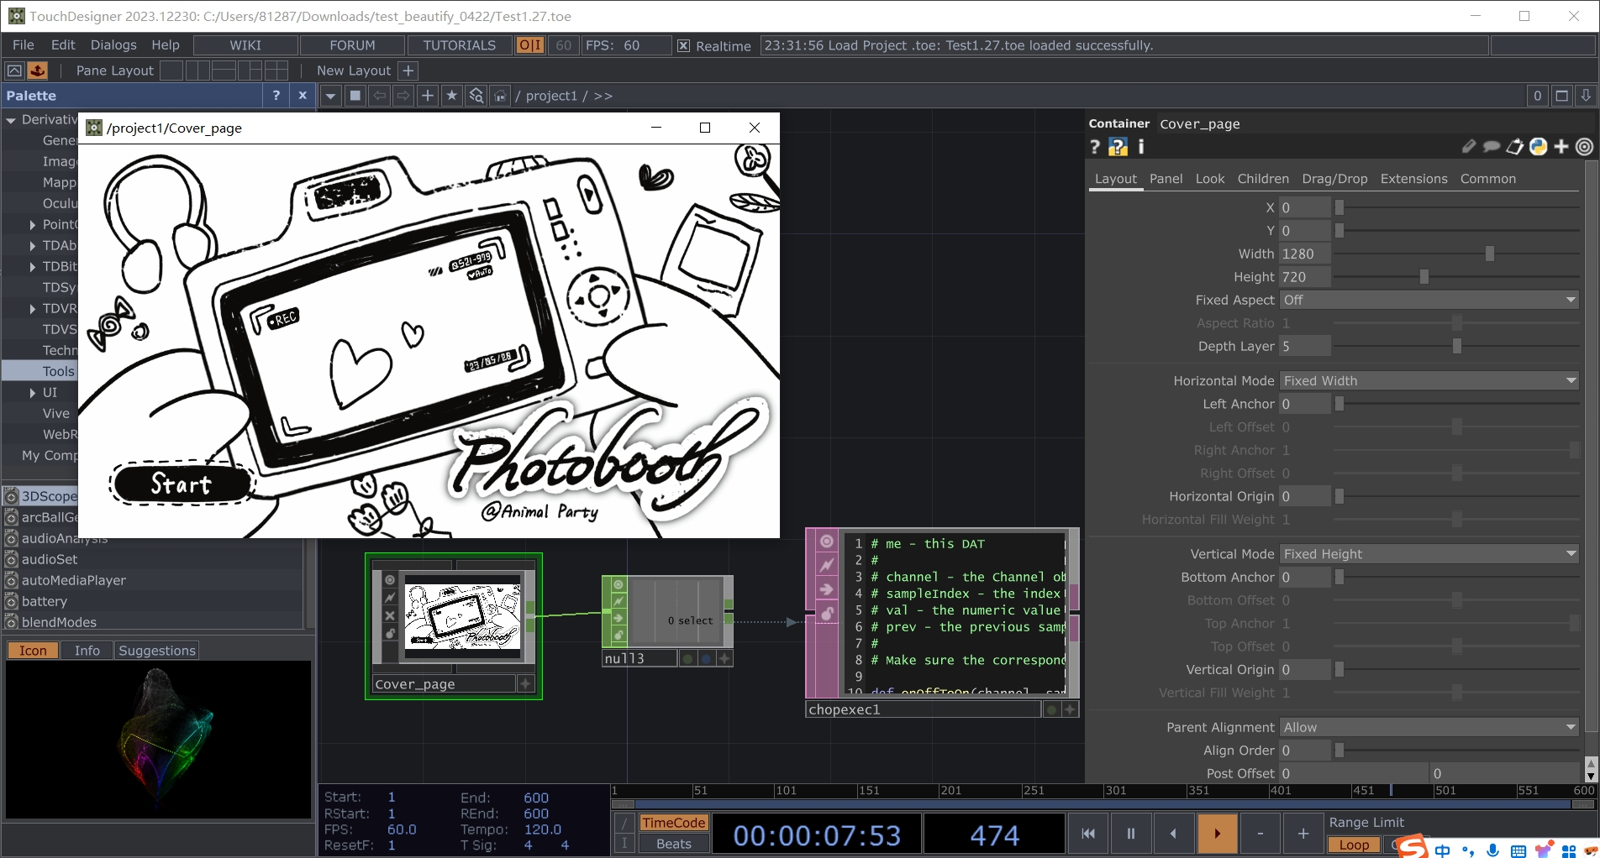
TouchDesigner 编辑器实景 — PhotoBooth cover_page UI(Photobooth @Animal Party 手绘相机)+ 节点网络 + PhotoBooth Extension 参数面板
TD 编辑器实景:PhotoBooth Extension 运行态 — 封面页手绘 UI + 节点网络 + 参数面板

5 轮迭代时间线 · 3 周交付节奏

Round 1 · 0403

基础 Pipeline POC

ComfyUI workflow 跑通 + TD 基本界面 + API 通信验证

Round 2 · 0410

LoRA 选型与集成

4 角色测试评估 + workflow JSON 参数调优(CFG / denoise)

Round 3 · 0417

状态机 + 并行架构

5 步状态机完整实现 + Multi-Pose 4 分支并行 + BiRefNet 集成

Round 4 · 0421

系统集成 + 压力测试

PHP 上传服务对接 + Approve/Retake 打磨 + 异常捕获全覆盖

Real Final · 展前

现场可独立运行版

Panel 缓存优化 + 完整文档体系(README + setup + extension docs + CHANGELOG)

Python 状态机

5 步 + HITL

Approve / Retake 分支 · 异常回退

交付节奏

5 轮 · 3 周

Round 1 → Real Final

39

五环复盘 / STAR Reflection

从「用 AI」到「编排 AI 系统」

STAR 五环 · 核心叙事

① 起点 / Situation

班级共建 LoRA 协作生态中,作为衍生 agent 设计者,把 6 个异质 AI 模型编排为一套现场可独立运行的互动拍照亭。

② 约束 / Tension

三层约束叠加(协作生态 / 展览可靠性 / 交付节奏)+ 三重张力(实时感 / 一致性 / 可靠性)。

③ 关键决策 / Actions

4 关键决策:LoRA 选型(Q1)→ ControlNet 姿态解耦(Q2)→ SOA 三层服务(Q3)→ HITL Approve/Retake。

④ 量化结果 / Results

6 模型 / 5 类技术 · 5 步状态机 · 5 轮迭代 · 60+ 版本 · 受邀 PolyU 年度设计展。

⑤ 认知升级 / Reflection · Hero

AI 全栈设计师 = 为每个子任务配一个专职模型,再设计编排层让它们协同表演。

三层抽象:Model layer(每子任务一个专职模型)→ Orchestration layer(TD as conductor)→ Service layer(三进程隔离)。

2 项核心收获

① 编排思维 vs 使用思维 — AI 系统设计的核心 = 理解每个工具的能力边界 + 设计编排层让它们协同工作

② 架构决策 = 风险分配决策 — 三层进程隔离在展览当天的可靠性上直接体现工程价值

4 维验证矩阵

维度 方法 节奏 成立
角色一致性稳定性 统一 base Prompt + 多次生成对比 + strength 1.0 边界测试 LoRA 选型阶段(Round 2)+ 每轮迭代回归 ✓
跨层 API 通信可靠性 TD→ComfyUI 成功率测试 + 错误注入(断网 / 崩溃 / 服务挂起) Round 3 → Round 4 ✓
现场 UX 流程完整性 端到端流程测试 + 模拟「第一次用户」+ HITL 行为验证 Round 4 → Real Final ✓
快速迭代节奏可追溯 GitHub commit log + 日期文件夹版本快照 + CHANGELOG 全 5 轮(3 周) ✓

3 项改进方向

① 实时生成路径升级 — StreamDiffusion + ControlNet 实现真正实时姿态跟随(参考眾生鏡架构,需重新评估 LoRA 兼容性)

② 观众实测数据 — 满意度评分 / 重拍率 / 角色选择分布 → 为 HITL 介入点提供量化验证(升级至 5 维矩阵)

③ Storyworld 生态扩展 — 打通班级 LoRA 库 API 接口,让任意同学创作的角色可被动态召唤(静态 4 角色 → 动态协作生态接入)

ComfyUI 60+ nodes TD 跨进程 API BiRefNet 语义分割 HITL Approve/Retake
40

跨学科实践 / Cross-Disciplinary Practice

独立交付 4 张策略可视化图表 — 把跨媒介叙事框架翻译为平台分工的视觉语言

《蔬菜历险记:变革之根》· SD5974 Digital Storytelling for Transmedia · Group Project

我主导策略架构设计、独立完成全部四张信息可视化图表(队友负责角色美术与插图)—— 基于 Jenkins 七原则 + Gee 情境学习框架,把 Game / AR / Meme Stickers / Social Media 四平台的职能分工与用户参与阶梯,翻译成可读的视觉语言。
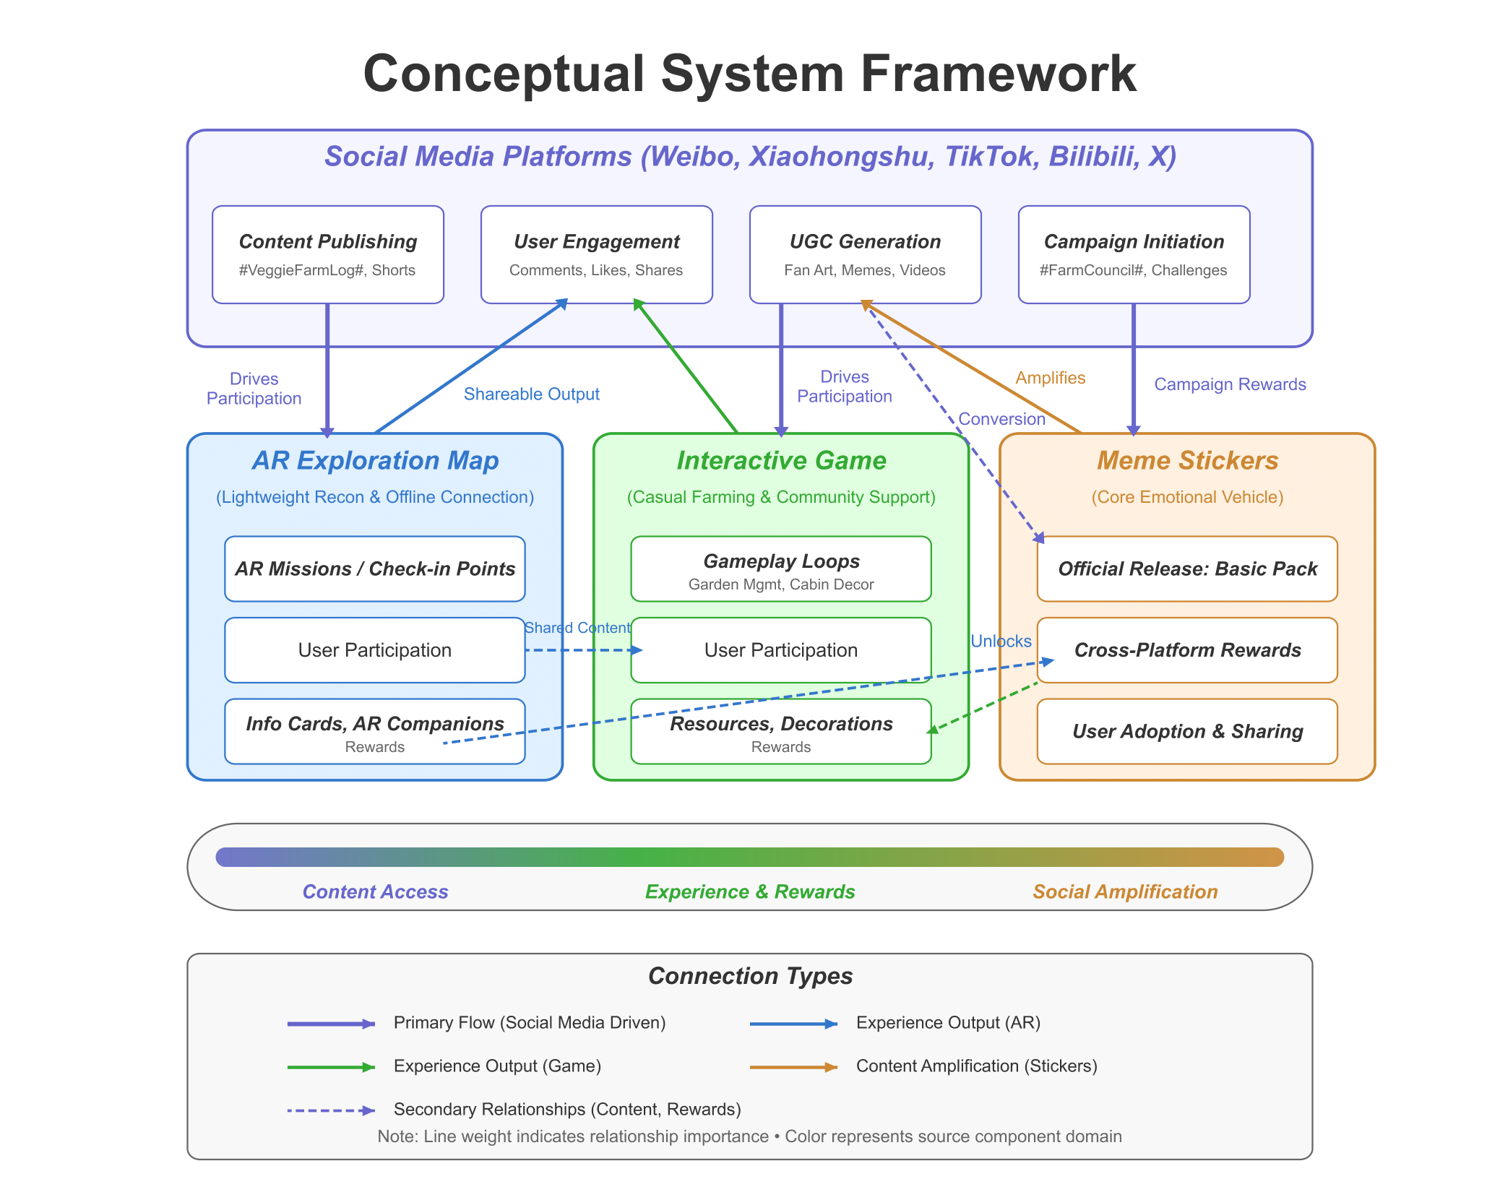
Figure 1 · Conceptual System Framework — 四平台节点 + 信息流向 + 用户旅程阶梯

01 · 系统架构

概念系统框架图

把四平台职能分工与信息流压进一张可读系统图 — 颜色编码节点 + 4 类箭头区分流向语义
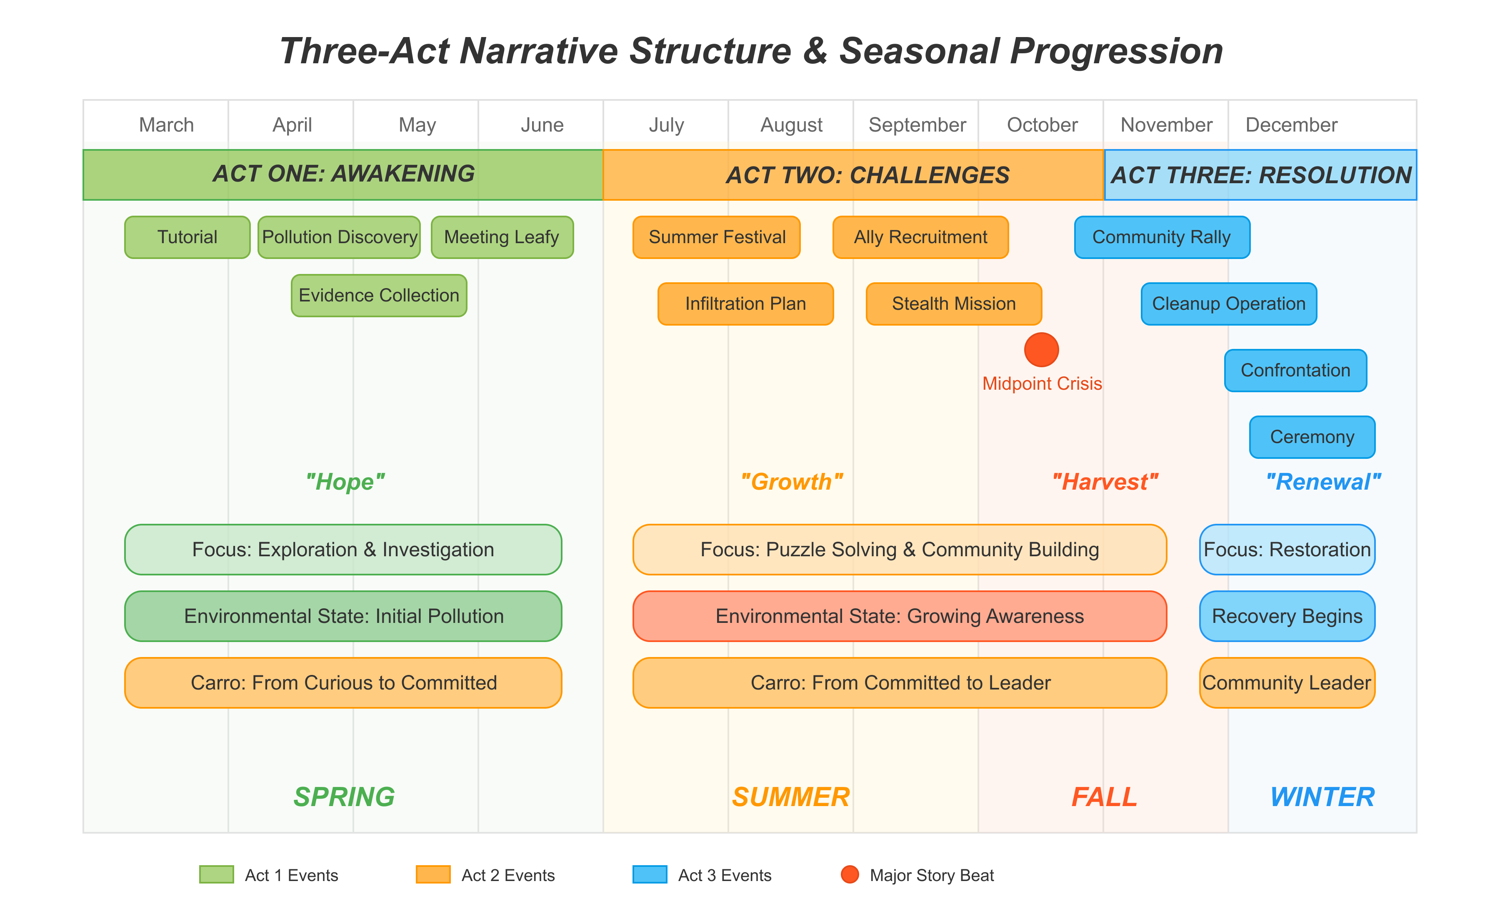
Figure 2 · Three-Act Narrative Structure & Seasonal Progression — 三幕结构映射四平台触点 + 角色弧线

02 · 时间结构

三幕叙事时间轴

把抽象三幕结构落到时间轴 — 四平台触点与角色弧线的激活时序
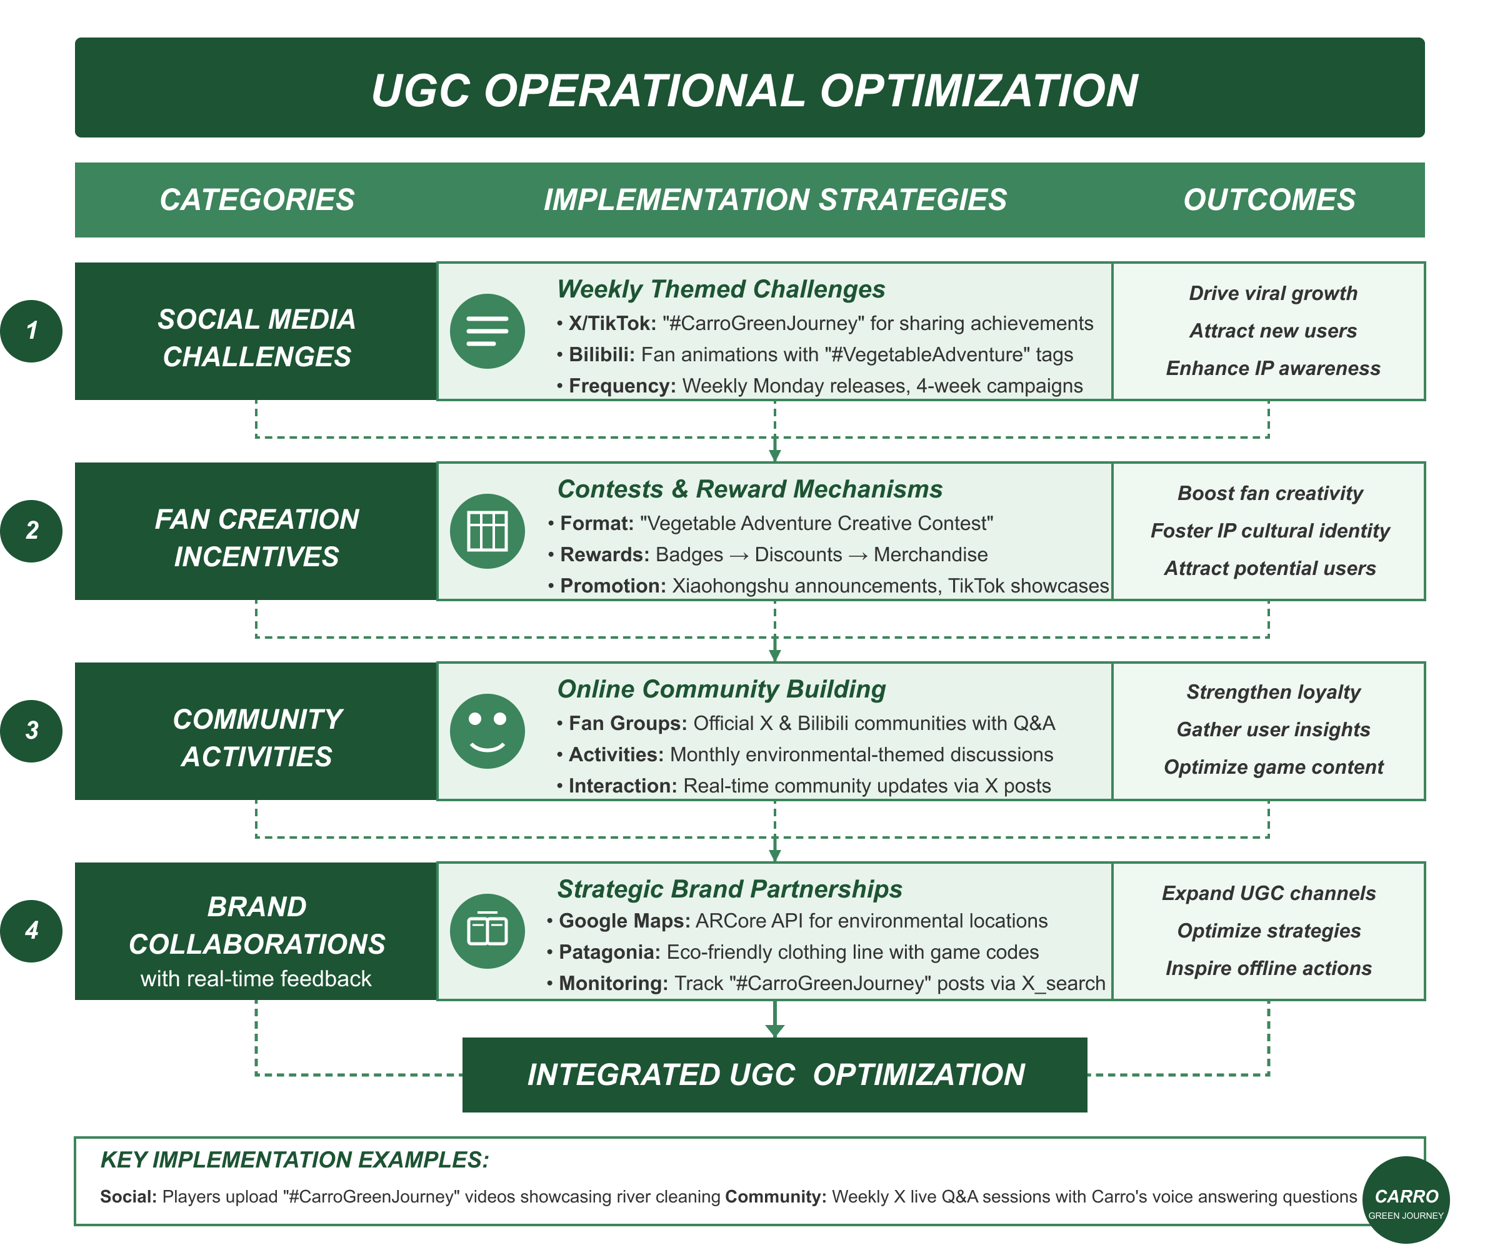
Figure 3 · UGC Operational Optimization — 低门槛入口到深度投入的转化漏斗 + 内容回流

03 · 运营转化

UGC 运营流程图

把用户参与路径画成转化漏斗 — 低门槛入口 → 深度投入 + 内容回流主线
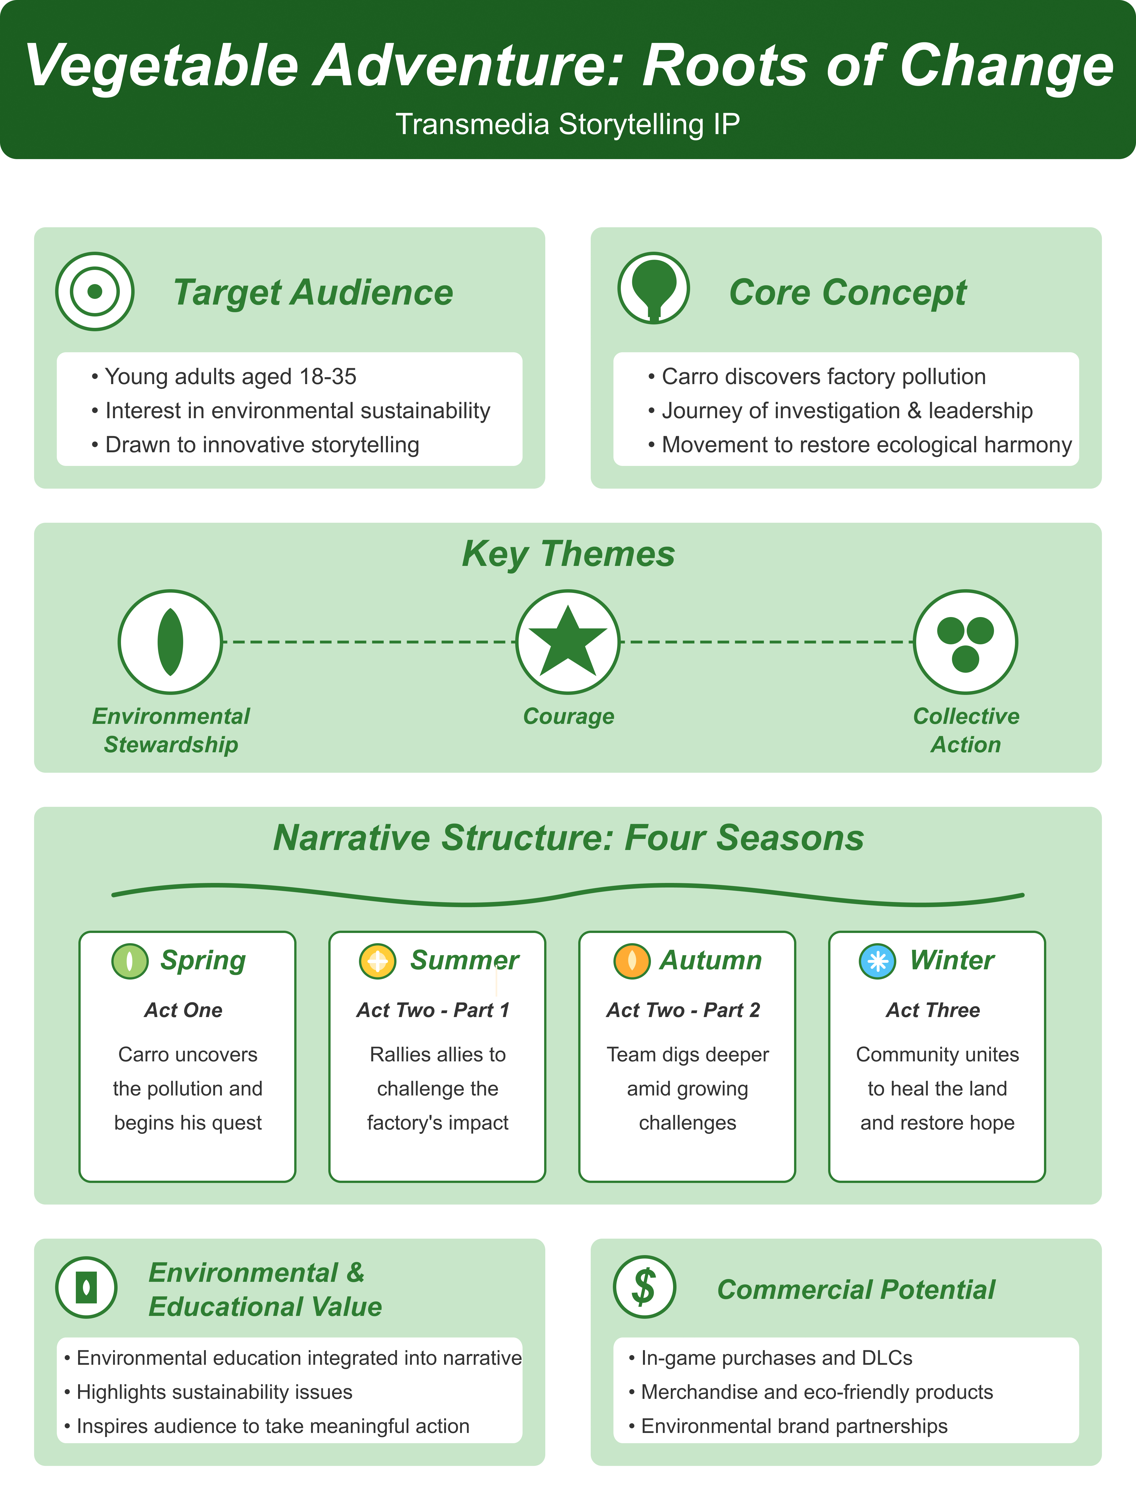
Figure 4 · Vegetable Adventure 叙事 IP 概览 — 受众/核心概念/主题/四季叙事/教育与商业价值

04 · IP 总览

叙事 IP 概览图

把 IP 世界观收敛成一页 — 受众 / 核心概念 / 主题 / 四季 / 价值五面

41

其它作品 · 展览策划实战 / Other Works · Exhibition Practice
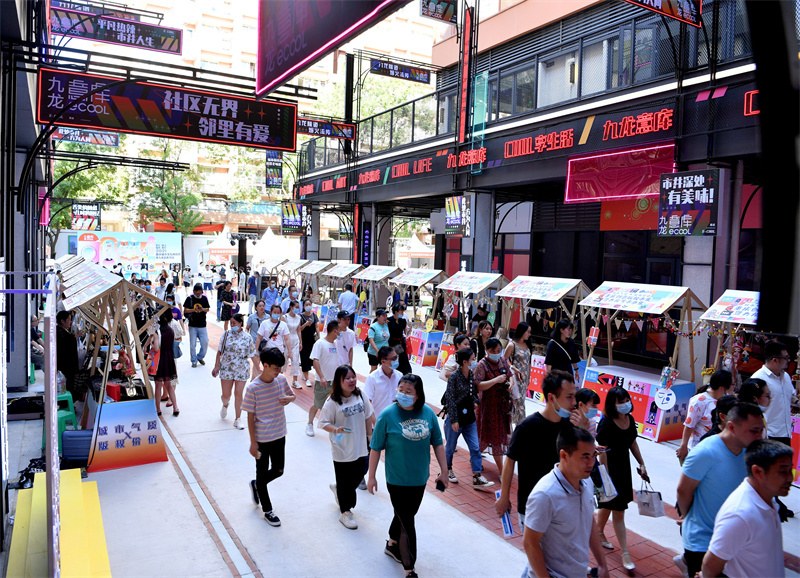
十方艺术展览策划实战 — 服务设计与体验优化能力切片

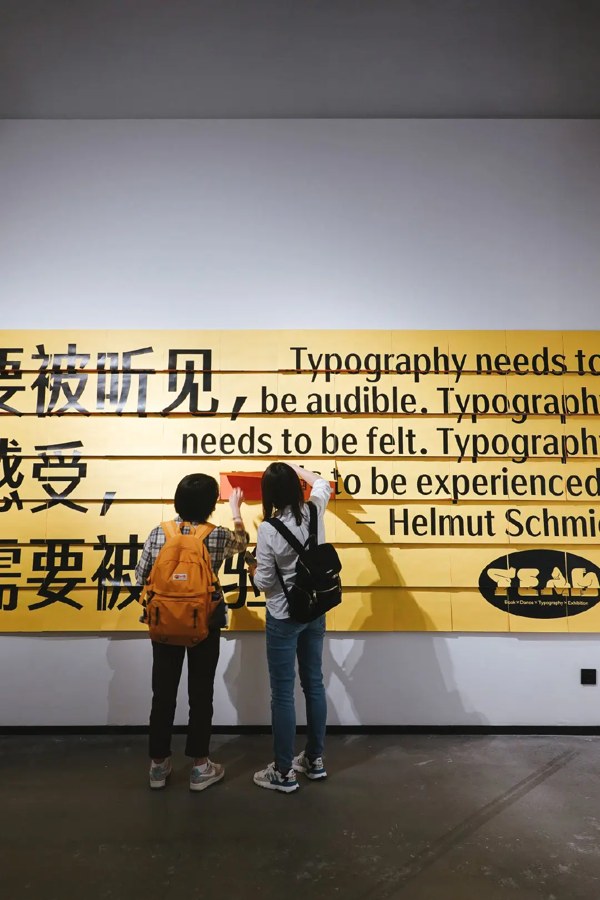
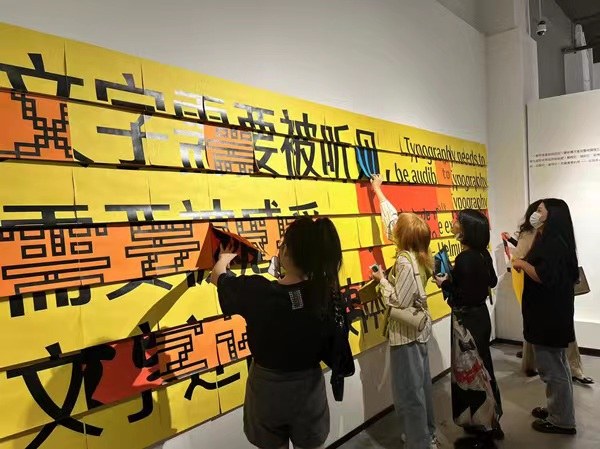
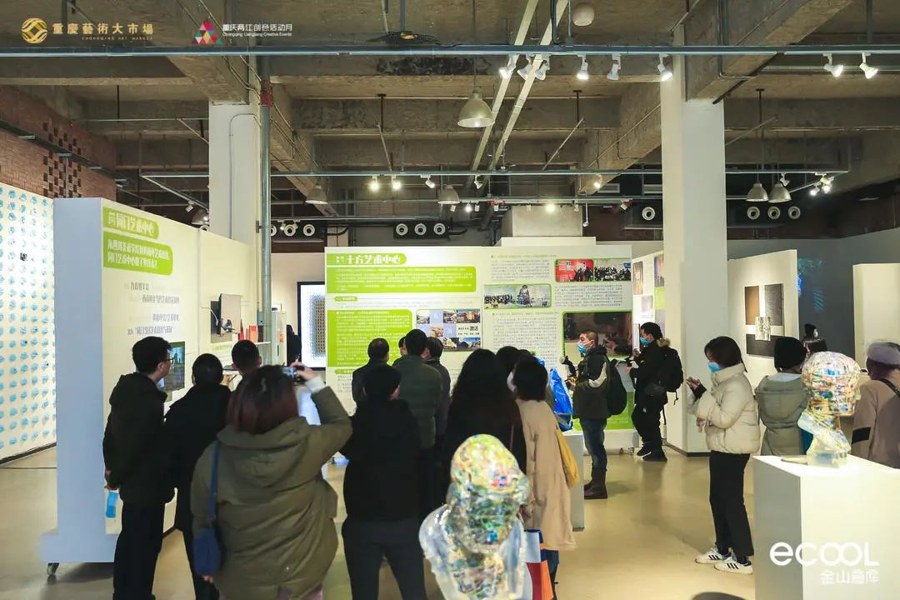
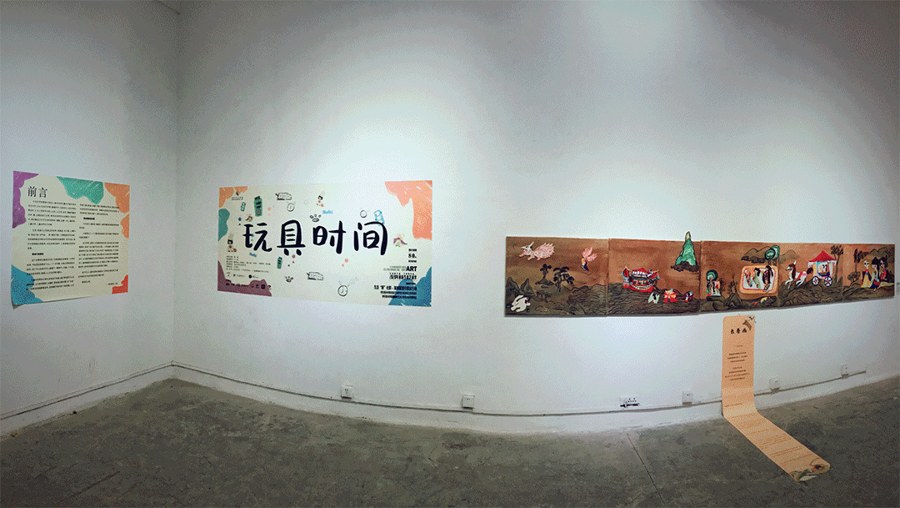
十方展览现场 — 街区展览人流 十方展览现场 — 「被看见」typography 主题展墙 十方展览现场 — 黄色主题展墙观展 十方展览现场 — 美术馆展厅人流 十方展览现场 — 「玩具时间」主题展墙
十方艺术文化创意中心 · 5 场展览现场实拍 — 空间导览路径优化实战

十方艺术文化创意中心

2020.12–2022.06 · 重庆

展览体验优化

主动识别「停留短、参与低」体验断点,重新设计观众行为动线与空间导览路径;5 场展览停留时长 +30%,转化 300+ 观众为活跃参与者

完整展览 / 创意作品集 2018–2023 · yeezeon.cargo.site ↗

展览停留时长

+30%

5 场展览

活跃参与者

300+

观众转化

服务设计 行为动线 空间体验 展览策划
42

结语 / Closing · Awards · Publications · Contact

奖项、学术发表,与正在寻找的下一站

Selected Awards

圆点设计奖三等奖

Dot Design Award

2023

BICC 铜奖

Baidu International Creative Competition

2023

香港大学生当代设计奖铜奖

HK Contemporary Design Award

2023

香港青年设计奖三等奖

HK Youth Design Award

2023

全国大学生广告艺术设计大赛二等奖

National College Advertising Art Competition

2021

新加坡艺术设计大赛铜奖

Singapore Art & Design Competition

2021

第二届国际大学生艺术年度奖铜奖

International University Students' Art Annual Award

2020

Research & Publications

研究课题 · 2023–2024

心理学研究方法在教育中的应用

导师

张晓教授,香港大学教育学院副教授暨研究生教育副院长

《视觉复杂性视角下学龄前儿童汉语阅读能力发展研究》
已发表 ·《新教育》· 2024

Education

香港理工大学

2024.09–2026.10

多媒体创娱理学硕士(MSc IME)

四川美术学院

2018.09–2022.06

视觉传达设计学士 · 入选跨媒体艺术工作室(CMS)· 连续两年院级优秀奖学金

Thank You for Reading

期待与您交流设计与 AI 的更多可能

yeezeon.li@connect.polyu.hk

Designed & Built by Yeezeon Li · Portfolio 2026
43